異位性皮膚炎問 AI 準不準?中文答案排倒數第二
異位性皮膚炎問 AI 可靠嗎?ChatGPT-4 答 99 題,英文平均 8.18–10 分(滿分 10)、無危險答案;換八種語言,中文 4.23 分(滿分 5)倒數第二。都沒有醫師對照組。
本篇分成 10 段
她在搜尋框裡打的是:「我在冷天出去走了一圈,現在全身起蕁麻疹。」
沒有附照片。Google 的 AI 摘要回她:可能是寒冷性蕁麻疹(cold urticaria)。
Kimberly Fu 六個月大時被診斷異位性濕疹,她說這 25 年來,病況一直在變,什麼適合自己,都是一路試出來的。她在 Pierre Fabre 主辦的 International Forum of Dermatology 2026(IFD 2026)〈AI & Eczema〉這一場,以病人倡議者的身分上台,講她怎麼用 AI 管自己的皮膚。這個例子她給的評價很節制:AI 給了她一個起點,一個可以帶去問醫師的具體名詞。
同一場的第二位講者是美國西北大學皮膚科的 Peter Lio。他把自己團隊這兩年做的研究攤開:讓 ChatGPT 回答異位性皮膚炎病人常問的問題,再請皮膚科醫師打分數。
Lio 團隊請 ChatGPT-4 用英文回答 99 個異位性皮膚炎常見問題,國際皮膚科醫師給分(1 到 10 分),各題平均落在 8.18 到 10 分,沒有一則被標為危險資訊。
換成八種語言、101 題、1 到 5 分再測一次,最低是巴西葡萄牙文 3.98,中文 4.23 排倒數第二,作者認為原因是中文網路上中醫與益生菌的資訊太多。
兩篇都是一頁長的短篇研究,沒有拿醫師的回答來比,打分數的醫師知不知道答案出自 AI,論文沒寫。作者群裡有主辦方 Pierre Fabre 的員工。
她把月經週期和皮膚寫在同一張表上
Kimberly 講的困難,皮膚科門診天天聽得到:擦藥的時間、份量,不多擦也不少擦,日復一日,她用「沒完沒了」來形容,對孩子和青少年尤其累。誘因找不完,「我們都變成自己的研究員」。換一位醫師,病史就要從頭再講一次。
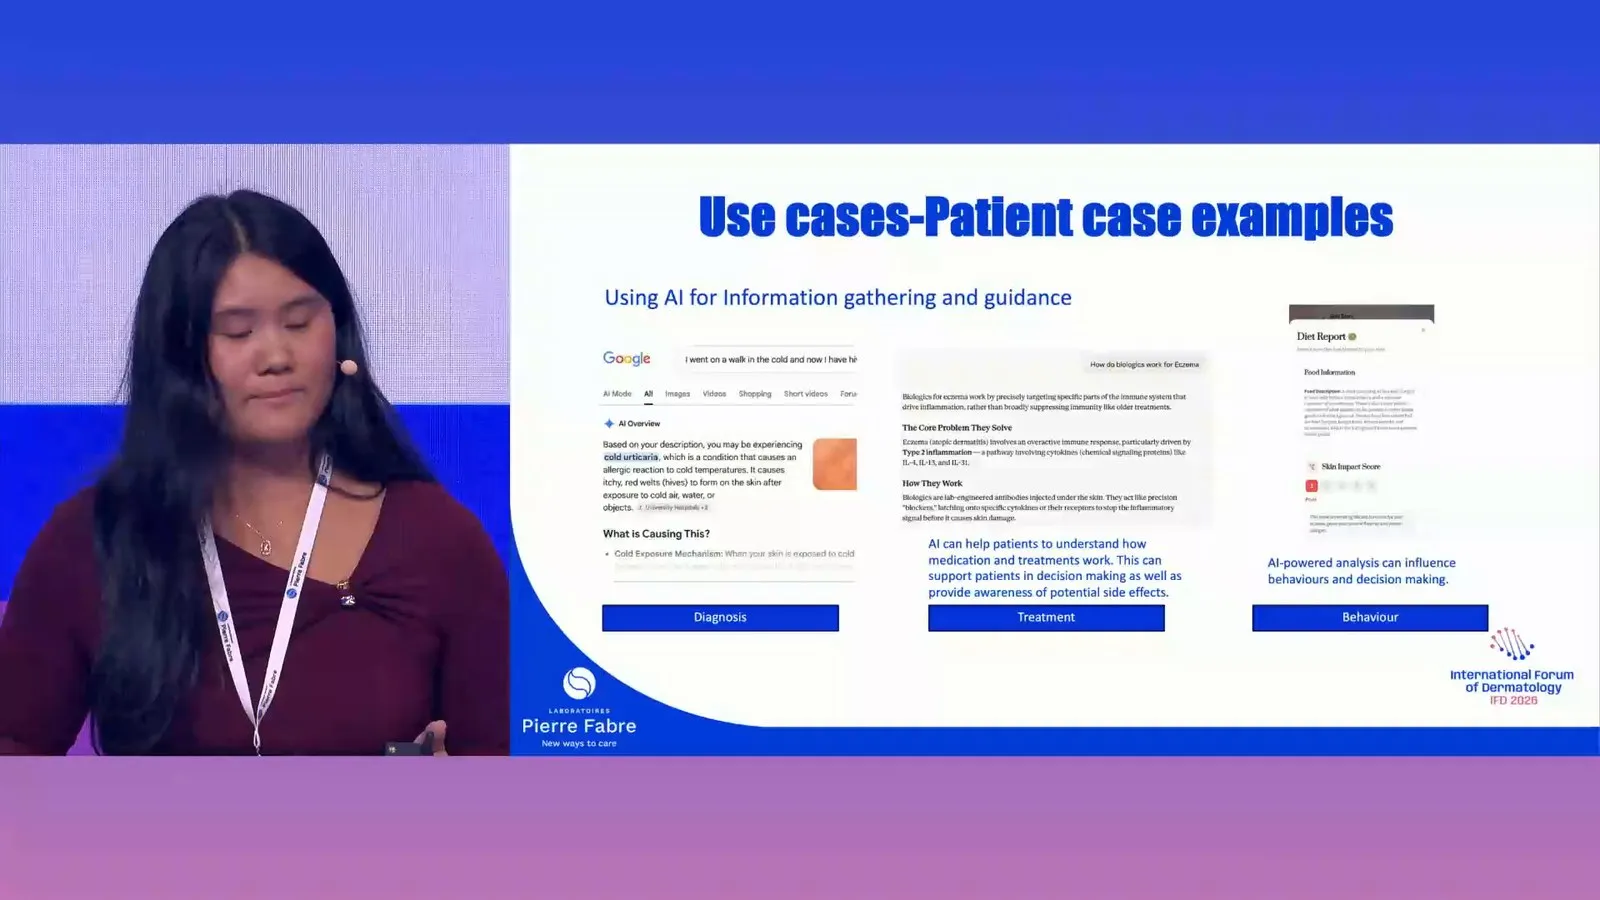
左邊是那則寒冷性蕁麻疹的 Google 搜尋,標「診斷」;中間是她問 AI 生物製劑怎麼作用,標「治療」;右邊是 App 分析一餐照片、依「有實證的濕疹食物誘因」打分數,標「行為」。
第二個例子她補了一句:AI 給的副作用與使用說明,她還是可能存疑,還是要找皮膚科醫師確認。
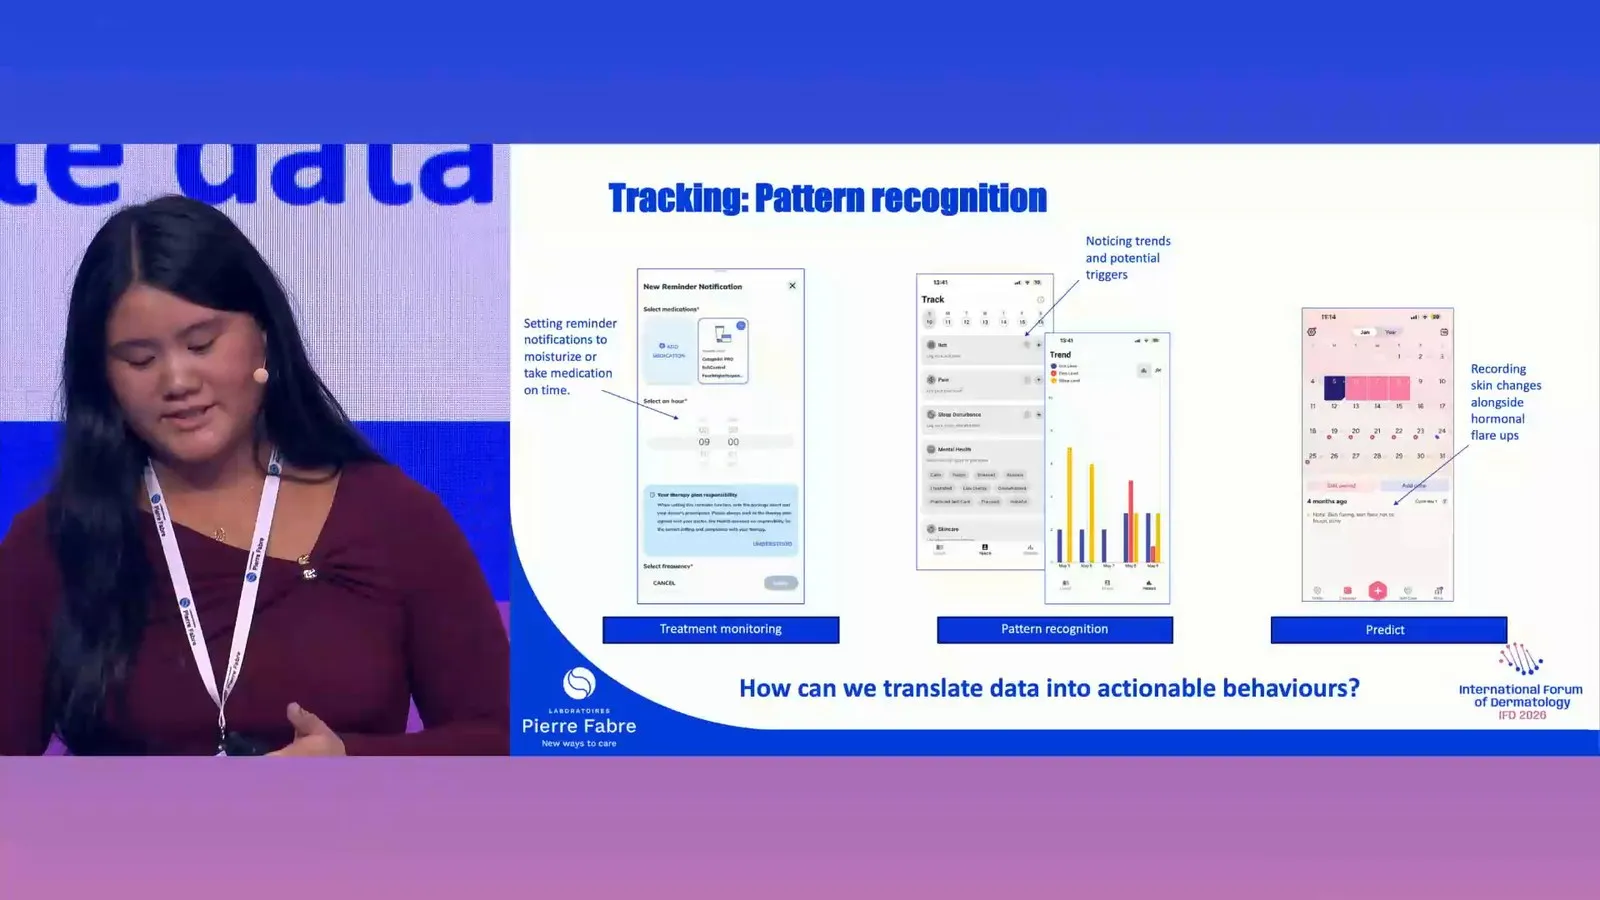
左邊是擦保濕、吃藥的提醒;中間的 App 記錄癢、痛、睡眠干擾,畫成長條圖找趨勢與誘因;右邊是她把皮膚變化記在月經週期的月曆上。底下那行字問:資料要怎麼變成做得到的行動?
月曆那一格是她自己的發現:週期的某幾個時點,皮膚會變差。知道了,她可以預期下一次發作,也可以把紀錄帶進診間當證據。
她也提到,有些 App 用的是臨床驗證過的量表,像 POEM(病人自評濕疹量表)和 EASI(濕疹面積與嚴重度指數)。EASI 原本是醫師評分用的工具,病人自己在 App 上打,跟醫師打的分數未必對得起來。這些紀錄都要持續做才有用。
她的投影片上有一句:「追蹤症狀有時像一份工作。」(Tracking symptoms can feel like a task.)
她擔心的是錯誤資訊與隱私
Kimberly 擔心的事比她用的工具還多。奇蹟療法、速效偏方到處都是,一個急著找答案的病人,很少有餘裕分辨真假。自己問 Google 或 ChatGPT,找到一個「好像符合」的病名,就可能去治一個自己沒有的病。
還有資料。她追蹤症狀、輸入個人資料、問 AI 很私密的問題,這些東西去了哪裡?工具是用什麼資料訓練的?她的原話是:這些工具,真的是為像我這樣的人做的嗎?
她的結論投影片寫:病人已經在用 AI,需要的是怎麼安全使用的指引。台上她又加了一句:AI 不是適合每個人。
台下只有 3% 的人還沒用 AI
Lio 一開場就請台下掃 QR code 投票。
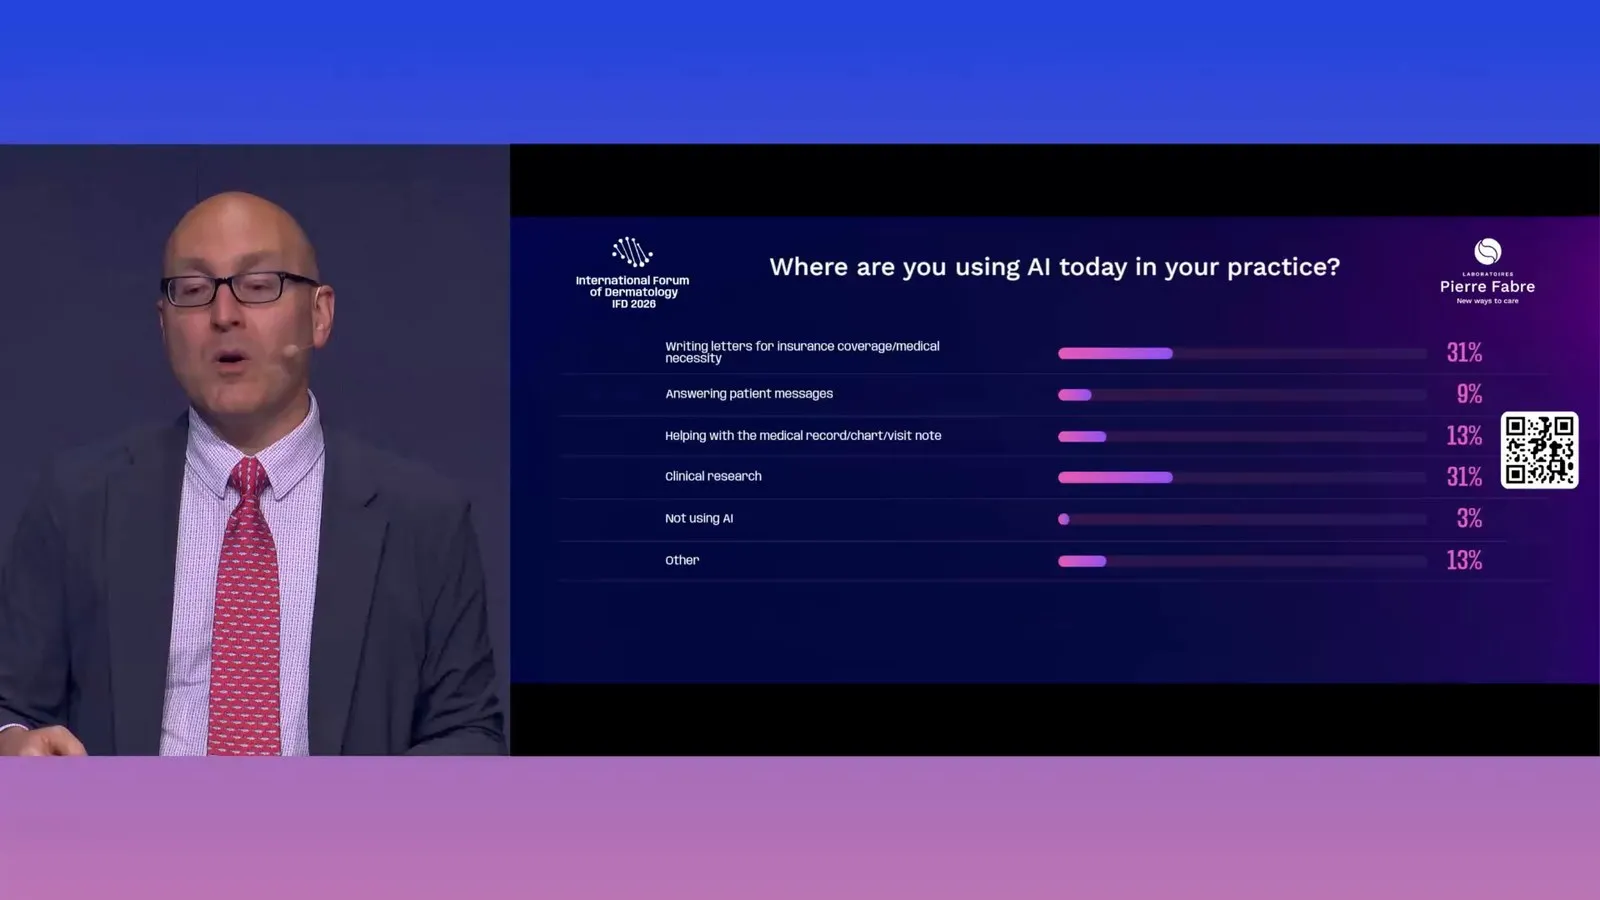
結果:寫保險給付與「醫療必要性」信函 31%、臨床研究 31%、病歷與看診紀錄 13%、回覆病人訊息 9%、其他 13%,還沒在用 AI 的 3%。
演講尾聲他再問一次「未來會在哪裡用」:病歷與看診紀錄跳到 41%,臨床研究 25%,保險信函 16%,回覆病人訊息 12%。
這是現場自願掃碼的與會者,投影片沒有顯示回答人數,來參加一場以 AI 為主題的會議,本身就偏向對 AI 有興趣的人。拿它當這群人當天的心情紀錄可以,當成皮膚科醫師的普遍狀況就不行。同一個會議會前問卷的數字,整理在〈皮膚科醫師用 AI 嗎?IFD 2026 圓桌與 109 份問卷〉。
99 題拿到 8 分以上,但沒有醫師的答案在旁邊比
Lio 說,回覆病人訊息是他最在意的負擔:每一則都是有人在求助,他想回得及時、親切、正確,訊息卻一天幾十則。
所以他的團隊做了這個測試。2024 年 1 月刊在 JEADV 的致編者信寫得很清楚:11 位國際皮膚科醫師各提供最多 10 個「病人常問的問題」,湊成 99 題,用英文輸入 ChatGPT-4,再由一群從事病人治療衛教的國際皮膚科醫師,用 1 到 10 分評品質與可靠度,並標出有沒有有害資訊。
台上 Lio 的說法是「99 個真實病人的問題,拿掉個資」;論文寫的是醫師提供的常見問題。他說是 0 到 10 分,論文寫 1 到 10 分。差別不大,讀原文時知道就好。
結果:
- 各題平均 8.18 到 10 分,標準差 0 到 1.76
- 沒有一則被標為危險資訊
- 大多數回答會說明自己不是醫師,並建議找醫療人員
- 分數較低的,是答得不完整、或建議偏離實證的那幾題
論文附了五題示範。「濕疹是什麼原因造成的」拿 10 分。「最有效的保濕劑是哪些」拿 9.18 分,標準差 1.08,那一則 ChatGPT 直接列出五個市售品牌的產品名稱。
Lio 在台上說,很多時候他覺得 ChatGPT 的回答比他自己寫的好。這是他個人的感受,研究本身沒有量:99 題旁邊沒有醫師寫的答案可以比。
有比的研究是另一篇。他在同理心那張投影片引用 2023 年 JAMA Internal Medicine 的研究:從 Reddit 的 r/AskDocs 論壇隨機抽 195 則已有認證醫師回覆的提問,同一題再丟給 ChatGPT,兩份答案打亂順序,由醫療人員評比。585 次評比裡,78.6%(95% CI 75.0%–81.8%)選了聊天機器人的答案。品質「好或很好」的比例,聊天機器人 78.5%,醫師 22.1%;「有同理心或很有同理心」,45.1% 對 4.6%。
這組數字要配著另一個數字讀:醫師回答的字數中位數 52 個字,聊天機器人 211 個字。醫師是在論壇上無償、隨手回答陌生人,不是在診間面對自己的病人。開場那一場也引了同一篇,〈AI 會取代皮膚科醫師嗎?IFD 2026 開場數字查核〉裡有拆解。
Lio 說,他回到第十二則訊息時,自己都察覺得到開始不耐煩;AI 不會,從頭到尾一樣客氣。這也是要小心的地方。2026 年 Nature 一篇研究把五個語言模型訓練得更溫暖、更有同理心,錯誤率反而上升約 10 到 30 個百分點,也更容易附和使用者原本就錯的想法,我整理在〈把AI訓練成暖男之後,它開始不敢說真話了〉。溫柔和正確,在模型裡可能是互相拉扯的兩件事。
換成中文,分數往下掉
第二篇研究 2024 年 9 月刊在 JAAD International。101 題,同樣用 ChatGPT-4,這次換成八種語言提問,由精通該語言的皮膚科醫師評分,1 到 5 分。
| 語言 | 平均分數(1–5) |
|---|---|
| 巴西葡萄牙文 | 3.98 |
| 中文 | 4.23 |
| 西班牙文 | 4.24 |
| 波蘭文 | 4.31 |
| 德文 | 4.33 |
| 法文 | 4.33 |
| 丹麥文 | 4.44 |
| 義大利文 | 4.62 |
台上 Lio 點名巴西葡萄牙文最低。對台灣讀者,要看的是第二列。
作者寫得很直接:中文低分的那幾題,問題不在模型的中文能力,在於中文網路上關於中醫與益生菌的資訊太多。ChatGPT 從網路上學,不分對錯。碰到缺乏實證的另類療法,它常回「可能有幫助」;作者認為,依現行指引,這類療法應該是不建議使用。
另一個細節:在非英文語言裡分數最低的五題,換回英文、由國際皮膚科醫師評,分數是 9.09 到 10 分(滿分 10)。同一個問題,換一種語言問,答案的品質就不同。
這篇沒有做統計檢定,也沒寫每種語言由幾位醫師評分。中文版本用的是簡體還是繁體,論文沒有寫。台灣的共同作者是台大醫院皮膚部的朱家瑜醫師。
AI 的答案會跟著提問語言的網路內容走,這件事在別的領域也看得到。〈35 變成 395〉那篇預印本發現,語言模型回答文化題時特別偏好某些國家,答案也受提問語言影響。
說錯的時候,也說得很有把握
Lio 放了一組 AI 生成的濕疹示意圖。2024 年那張,病人的手上多了幾根手指;2026 年用相近的提示詞生成的抓痕圖,已經看不出破綻。
他說,幾個月前還能拿來辨認 AI 的破綻,現在多半已經修好。修不好的是「虛構」:AI 會編,而且編得很有把握。人沒把握的時候會說「我不太確定,可能是這個」,AI 很少這樣說話。他引外科界的老話自嘲同業:有時候錯,從不懷疑(sometimes wrong, never in doubt)。
他引用一篇 2025 年 2 月上線、研究基礎模型醫療幻覺的預印本,說錯誤集中在檢驗數據的判讀和診斷預測,所幸少見,但後果可能很嚴重。這篇沒有經過同儕審查,之後也改版過:2025 年 11 月的版本測了 11 個模型,通用模型沒有幻覺的回答比例中位數 76.6%,醫療專用模型 51.3%;另外問了 70 位臨床醫師,91.8% 遇過醫療幻覺,84.7% 認為可能傷害病人。
Lio 的判斷是:至少未來十年,檢驗與診斷這兩塊,AI 都需要有人在旁邊看著。也許像自駕車,車上總要坐一個人。也許永遠如此。
讓聊天機器人直接看照片下診斷,數字更難看。同一個會議的毛髮場引了一篇瑞士研究:四個公開的聊天機器人判讀毛髮鏡照片,單一診斷平均只答對 18.2%,皮膚科醫師 58.1%——〈AI 看落髮到哪一步?IFD 2026 雄性禿與圓禿新治療〉。
AI 自己開處方這件事,美國猶他州已經在試,門檻與量的東西都很值得細看,見〈猶他州讓 AI 自己開痘痘處方:95% 是跟誰比?〉。
讓 AI 當帶路的人,不當醫師
Lio 最近在做的,是給 AI 加上護欄。
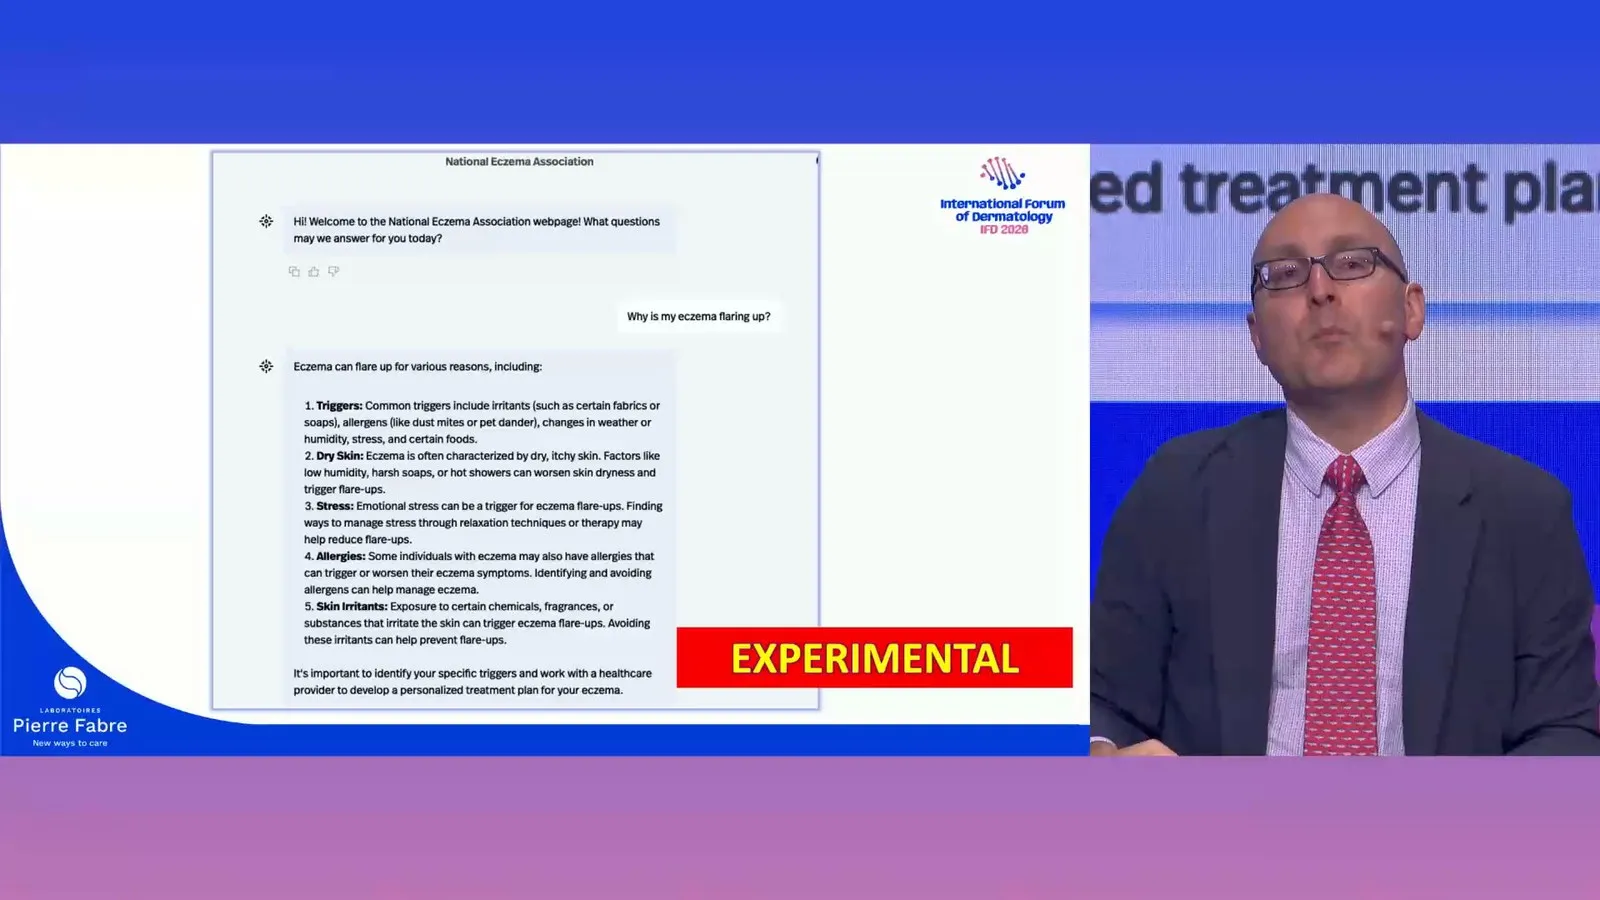
畫面上,使用者問「為什麼我的濕疹在發作?」,機器人列出刺激物、過敏原、天氣與濕度、壓力、皮膚乾燥幾類誘因,最後建議和醫療人員一起擬定個人化的治療計畫。右下角紅底白字:實驗性質。
他用一套商用的聊天機器人建置軟體(Pickaxe),餵進歐洲、美國皮膚科醫學會(AAD)、過敏聯合工作小組(Joint Task Force)等異位性皮膚炎指引,再經美國國家濕疹協會(National Eczema Association)同意,餵進整個協會網站。每個回答都附上出處連結:這一頁有更多說明、那一篇可以去看。
他喜歡的是這個轉向:AI 不再強調自己知道什麼,而是帶人找到對的資料。他形容它像一位管家。
這是試行,最後沒有正式上線,台上也沒有給任何準確度或使用成效的數字。目前只能當成一位醫師的試作經驗來看。
他押的是治療衛教
問答時主持人問:發作預測、影像分析、自動紀錄、治療衛教,三到五年內,哪一個最會改變異位性皮膚炎的照護?
Lio 說,影像分析和自動產生看診紀錄會被講得更多,但他私下押的是治療衛教。它的影響已經在發生,只是很難量、很難寫成論文,也不吸睛。
另一題問 AI 與 App 能不能讓病人更持續擦保濕。Kimberly 的回答是可以,提醒功能有用,但一定要有跟皮膚科醫師的互動:「我們一直在找某個人給我們回饋和方向,自己一個人很難走。」App 要夠成熟、夠好用,能放進本來就已經很耗時間的日常,才幫得上忙。
最後一題問哪些 AI 功能真的能減輕醫師的行政負擔。Lio 想要的是病人訊息的第一層分流,以及看診前讓病人先跟 AI 把問題講完、整理好。他描述的那一幕,門診醫師都熟:病人在診間滑手機,想找一張 1983 年拍的頭皮照片,計時器一直在走,最後一個問題在要離開時才想起來。
如果你是異位性皮膚炎的病人
這一場兩位講者,一位是病人、一位是醫師,結論很接近:病人已經在用 AI,問題是拿到答案和資料之後怎麼辦。我自己會這樣用他們的研究:
- 用中文問,答案打個折。 談到中藥、偏方、益生菌,AI 回「可能有幫助」時,記得 Lio 團隊的研究:這正是中文答案失分的地方。
- 把 AI 給的病名當問題,不當答案。 Kimberly 帶著「寒冷性蕁麻疹」這個詞去問醫師,這是好的用法。寒冷性蕁麻疹的病人,冷水游泳時可能出現全身性的嚴重反應。起疹子同時有喉嚨緊、呼吸困難、嘴唇或眼皮腫、頭暈快昏倒,不要再問 AI,直接去急診。
- 紀錄值得帶進診間。 照片、發作日期、和月經或季節的關係,比在診間憑印象講準得多。記得標日期。
- 問用藥,問完要回到醫師這裡。 生物製劑、口服 JAK 抑制劑、外用藥的差別,AI 可以幫你先看懂名詞;適不適合你、健保怎麼給付,給付條件請洽主治醫師。各類藥物的取捨,可以先看〈異位性皮膚炎怎麼選藥?亞洲人的免疫多走一條路〉。
- 個資留在自己手上。 這是 Kimberly 自己提的擔心:輸入 App 或聊天機器人的症狀、照片、私密問題,去了哪裡、被拿去做什麼,先看清楚再決定給不給。
參考文獻
- Sulejmani P, Negris O, Aoki V, et al. A large language model artificial intelligence for patient queries in atopic dermatitis. J Eur Acad Dermatol Venereol 2024;38(6):e531–e535. doi:10.1111/jdv.19737(PMID 38168874)
- Sulejmani P, Negris O, Aoki V, et al. The global reach of artificial intelligence in atopic dermatitis: The quality and reliability of ChatGPT responses in 8 languages. JAAD Int 2024;17:158–159. doi:10.1016/j.jdin.2024.08.013(PMID 40104109)
- Ayers JW, Poliak A, Dredze M, et al. Comparing Physician and Artificial Intelligence Chatbot Responses to Patient Questions Posted to a Public Social Media Forum. JAMA Intern Med 2023;183(6):589–596. doi:10.1001/jamainternmed.2023.1838(PMID 37115527)
- Kim Y, Jeong H, Chen S, et al. Medical Hallucinations in Foundation Models and Their Impact on Healthcare. arXiv:2503.05777(預印本,未經同儕審查;2025 年 2 月 26 日上線,2025 年 11 月 2 日改版)
- Pierre Fabre. International Forum of Dermatology 2026 replay: AI & Eczema “Personalized Dermatology”(Kimberly Fu、Peter Lio). https://pierrefabreformed.com/
en/ news/ pierre-fabre-ifd-international-forum-dermatology-2026
重要聲明
本文僅供衛生教育參考,不能取代專業醫師的診斷、治療或處方。實際用藥種類、強度與療程需由醫師依個別病況判斷。若症狀急速惡化、大面積起水泡、合併發燒或傷口化膿,請立即就醫。