AI 會取代皮膚科醫師嗎?IFD 2026 開場數字查核
AI 判讀黑色素瘤 95% 勝過醫師 86%?兩個數字是不同門檻下的敏感度;ChatGPT 較有同理心的研究用 Reddit 問答;防曬改善光老化 40–50% 來自 32 人、沒有對照組的研究。
本篇分成 8 段
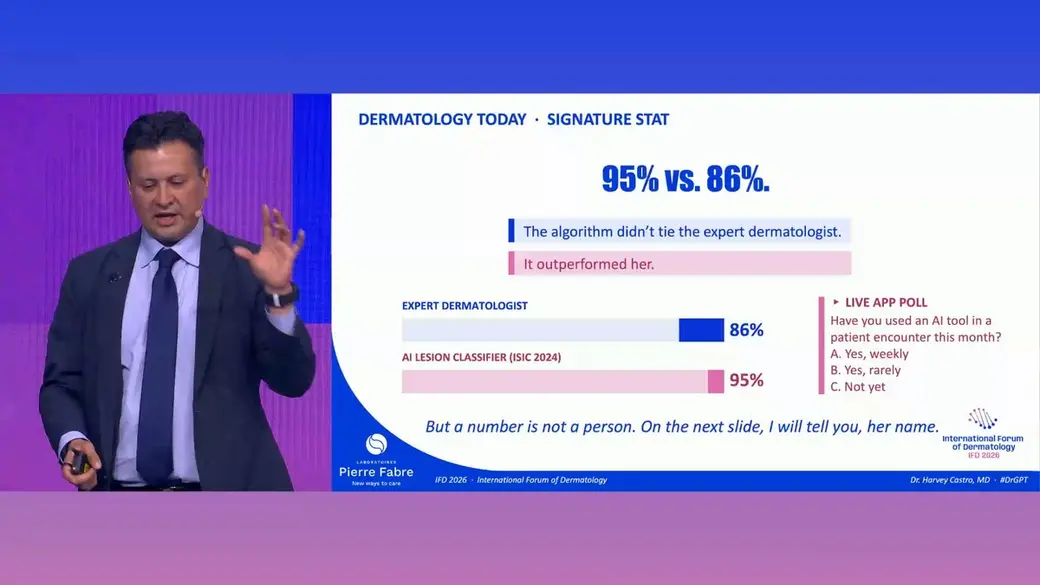
投影片上兩條長條,上面那條寫「專家皮膚科醫師 86%」,下面那條寫「AI 病灶分類器 95%」。旁邊一行字:演算法沒有跟專家打平,它贏過她了。
這是今年 6 月 Pierre Fabre 在葡萄牙波多舉辦的 International Forum of Dermatology 2026(IFD 2026),第一場〈AI & Disruptive Technology〉。三位講者:慕尼黑工業大學皮膚科的 Alexander Zink 教授主持並開場,美國急診醫師 Harvey Castro 講 AI 在醫療的今天和明天,義大利的 Giovanni Pellacani 教授介紹一個 Pierre Fabre 的防曬專案。
三個人的結論一樣:AI 加醫師,不是 AI 對醫師。這句話我同意。這篇整理的是他們拿來支撐這句話的研究,一篇一篇回去找原文之後,數字長什麼樣子。
「AI 95%、醫師 86%」這張投影片沒有標出處。數字最接近 2018 年一篇 100 張皮膚鏡難題的讀片研究:AI 的 95% 是敏感度,同時特異度只有 63.8%;58 位皮膚科醫師平均敏感度 86.6%、特異度 71.3%。兩邊在不同門檻上,不能直接比。拉到同一個敏感度,AI 的特異度是 82.5%,醫師 71.3%,AI 確實比較好,但差距沒有投影片看起來那麼戲劇化。
「ChatGPT 比醫師更有同理心」的研究,醫師端是在 Reddit 論壇義務回覆陌生人的醫師,回覆平均 52 個字,ChatGPT 211 個字。
防曬讓「光老化指標下降 40–50%」,出自一篇 32 人、沒有對照組、廠商主導的研究。有對照組的證據是 2013 年澳洲的隨機試驗:天天擦的人,4.5 年後皮膚老化少 24%。
穿戴裝置加語言模型:量到的是考卷,不是睡眠
Zink 教授一開場放了一張照片:一隻麻醉中的獅子,舌頭上綁著一支 Apple Watch,在量心跳。接著他問台下,誰手上戴著能量心電圖的錶,舉手的人他目測八成。
他的願景是:每個人隨時追蹤自己的健康曲線,一出現偏離,醫師就收到通知,不必再等一年一次、兩年一次的回診。穿戴裝置加上大型語言模型,就是隨身的健康教練。
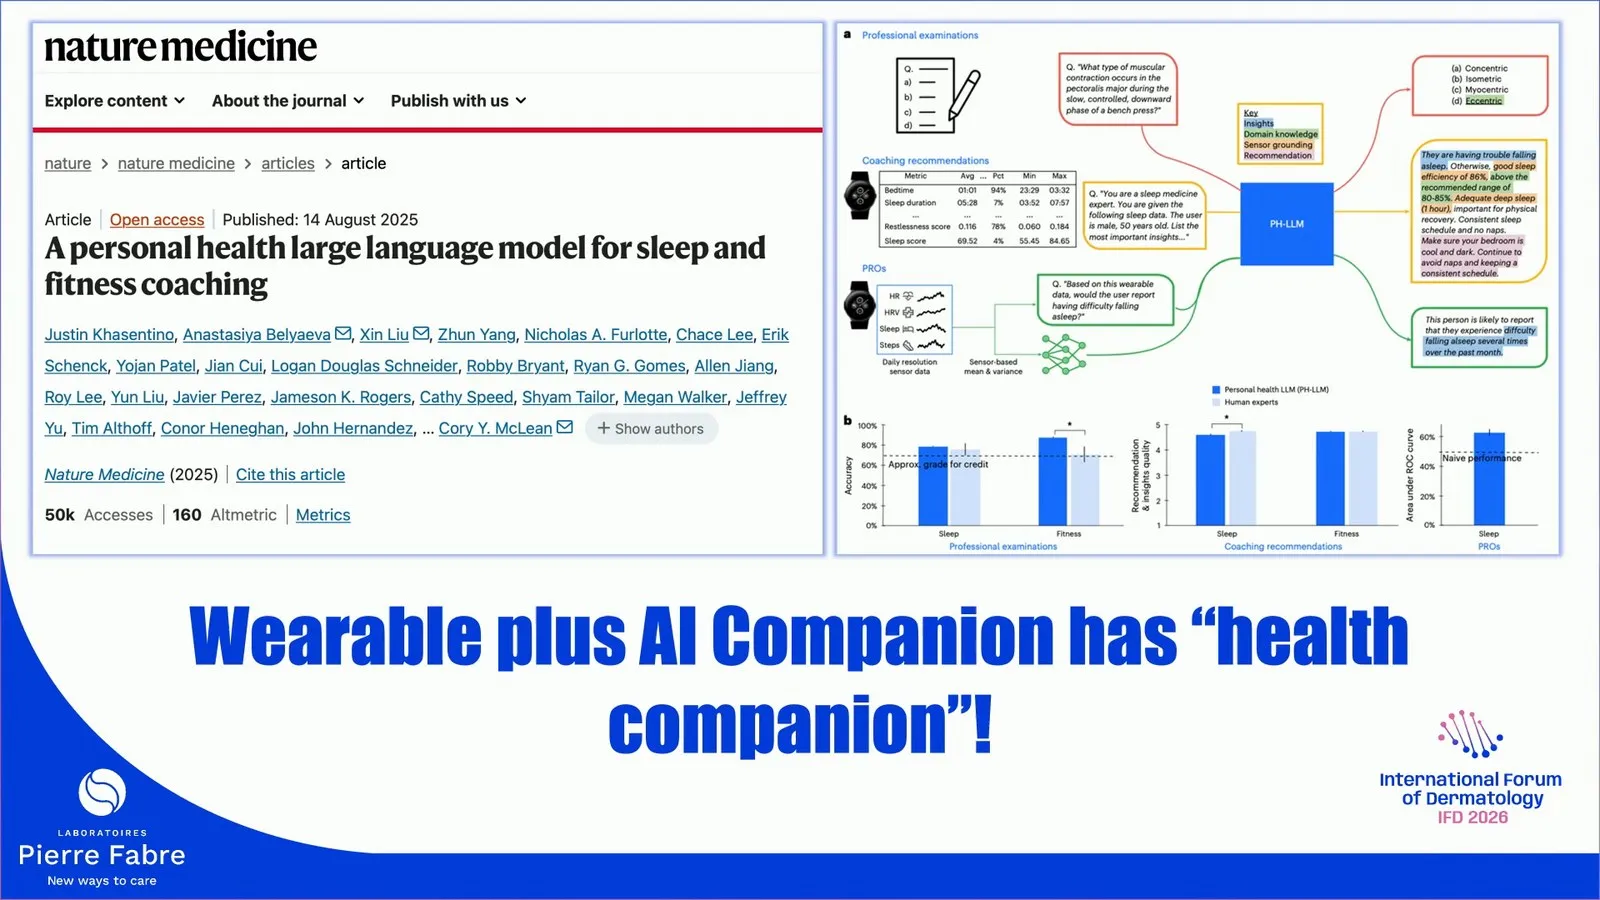 左邊是論文首頁,右邊是論文的流程圖與長條圖;下方大字寫「穿戴裝置加 AI 伴侶,就是健康伴侶」。
這篇是 Google 團隊 2025 年 8 月刊在 Nature Medicine 的 PH-LLM,把 Gemini 拿穿戴裝置每天的睡眠與運動數據微調。選擇題考試裡,它在睡眠醫學拿 79%,一組人類專家 76%;體能訓練 88% 對 71%。另外拿 857 個真實個案請它寫個人化建議,體能部分跟人類專家差不多。
Zink 教授口頭說,這樣的組合能改善我們的體能、改善睡眠。論文量的是 AI 考試的分數、寫出來的建議好不好、能不能從感測器數據預測一個人自評的睡眠品質。使用者照著建議做之後,睡眠和體能有沒有變好,這篇沒有量。研究由 Google 出資,作者全部是 Alphabet 員工。
ChatGPT 比醫師有同理心?醫師那一端是 Reddit
Zink 教授接著放了 2023 年 JAMA Internal Medicine 的兩張分布圖:回覆品質與同理心,ChatGPT 那一座山都在醫師右邊。
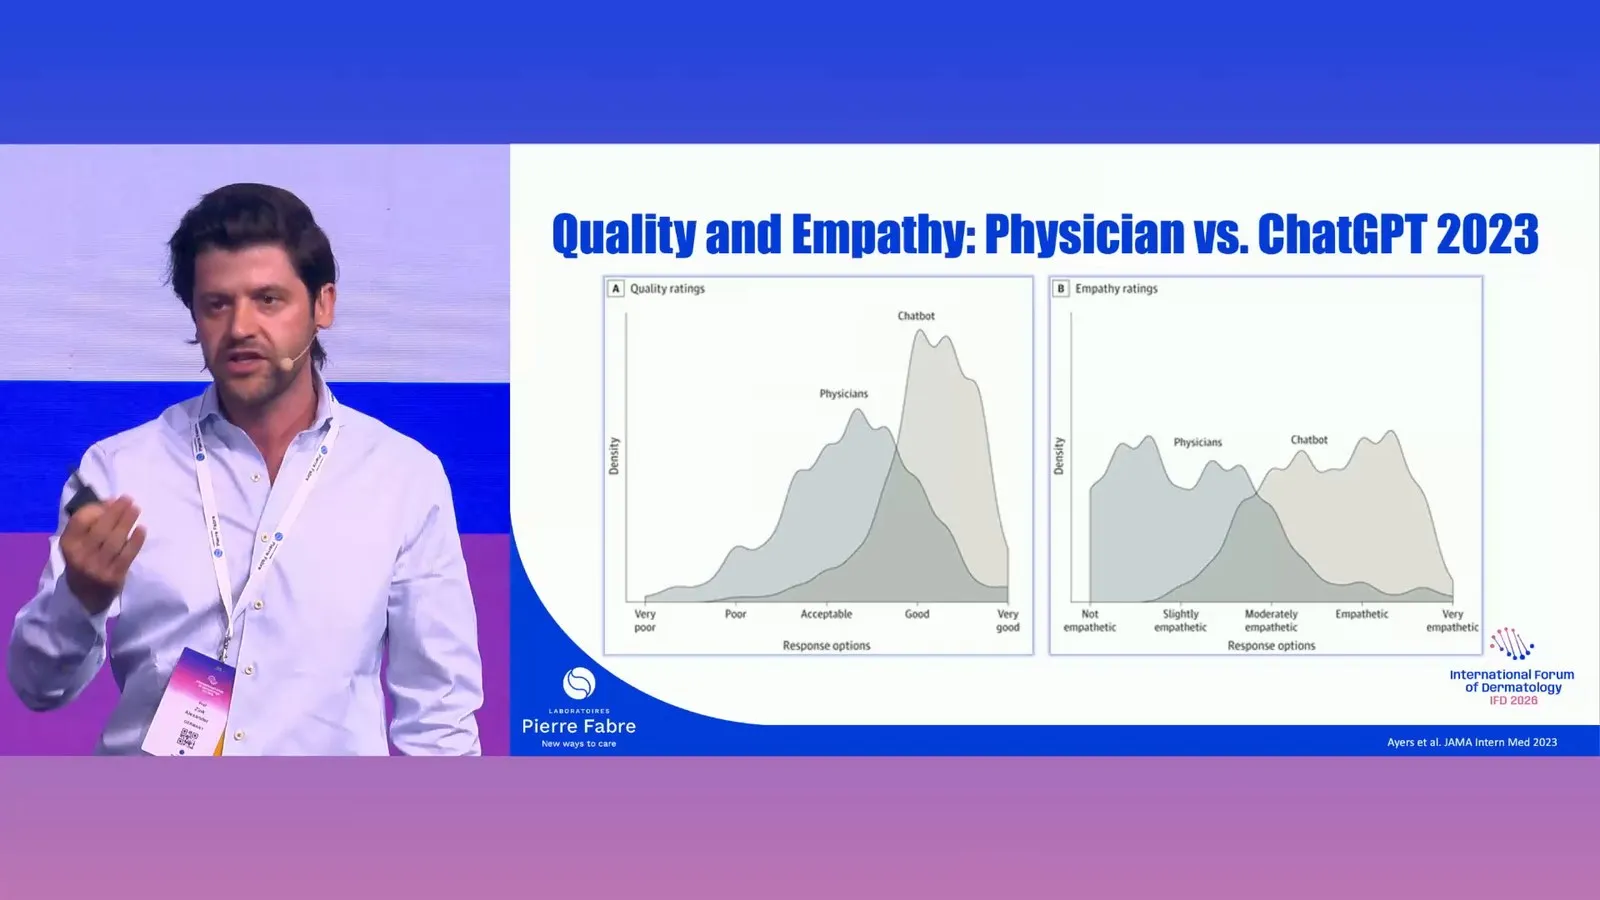 左圖是品質評分(極差到極好),右圖是同理心評分(沒有同理心到非常有同理心);深色的山是醫師,淺色的山是聊天機器人。
這篇研究從 Reddit 的 r/AskDocs 論壇隨機抽了 195 則問答:網友公開發問,經過認證的醫師回覆。研究者把同一個問題丟進 ChatGPT,再請醫療專業人員在不知道誰寫的情況下評分。
| ChatGPT | 論壇上的醫師 | |
|---|---|---|
| 評為「好」或「非常好」的比例 | 78.5%(95% CI 72.3–84.1%) | 22.1%(16.4–28.2%) |
| 評為「有同理心」或「非常有」 | 45.1%(38.5–51.8%) | 4.6%(2.1–7.7%) |
| 平均字數 | 211 字 | 52 字 |
585 次評估裡,78.6% 偏好 ChatGPT 的回覆。
對照組要看清楚。這些醫師是下班後在論壇上幫陌生人回一兩句,不是坐在診間、面對自己病人的醫師;回覆長度差了四倍,評分的人幾乎一眼就看得出哪一則比較用心寫。這篇證明的是 AI 能寫出讓人讀起來舒服的回覆,離「AI 比醫師更有同理心」還有一段距離。
Zink 教授的說法是:把工具訓練成人類想要的樣子,它就做得到。站上另一篇 Nature 研究給過反面的提醒——把語言模型訓練得更溫暖之後,錯誤率增加約 10 到 30 個百分點,也更常附和使用者的錯誤想法,見〈把AI訓練成暖男之後,它開始不敢說真話了〉。溫柔和正確,有時候要拿一個換另一個。
「虛擬實驗室」設計出來的,是新冠的奈米抗體
Zink 教授談 AI 進入研究端時,放了一張圖:一位人類研究者,下面一個 AI 擔任計畫主持人,再分出免疫學家、機器學習專家、計算生物學家三個 AI 角色,旁邊一個 AI 專門挑毛病。他口頭舉例,研究者可以說「我想找黑色素瘤的新藥」,幾秒鐘就有一個虛擬實驗室開始運作,而且證明它能創造新藥。
這是 2025 年刊在 Nature 的 Virtual Lab。它實際做的題目是:替新冠病毒的新變異株設計奈米抗體(nanobody,一種很小的抗體片段)。AI 團隊組出一套用 ESM、AlphaFold-Multimer 與 Rosetta 的設計流程,設計了 92 個新的奈米抗體;實驗室驗證後,有兩個對 JN.1 或 KP.3 變異株的結合變好,對原始病毒棘蛋白也仍然抓得牢。
所以題目跟皮膚科無關,產出的是可以再研究的候選分子,離「藥」還有動物實驗、臨床試驗好幾道關。人類研究者全程在旁邊給方向。黑色素瘤、乾癬是講者的假設舉例。
AI 當研究員的另一個例子,站上寫過 Google 與耶魯的模型自己提出抗癌假說、再進實驗室驗證的過程:〈AI當起科學家,Google揭示抗癌新地圖〉。
「醫學知識每 73 天翻一倍」是 2011 年的推估
Castro 醫師上台前先放了一段 AI 作的音樂。他擔心的是醫師過勞、被文書工作淹沒、提早退休,留下愈來愈老的病人。
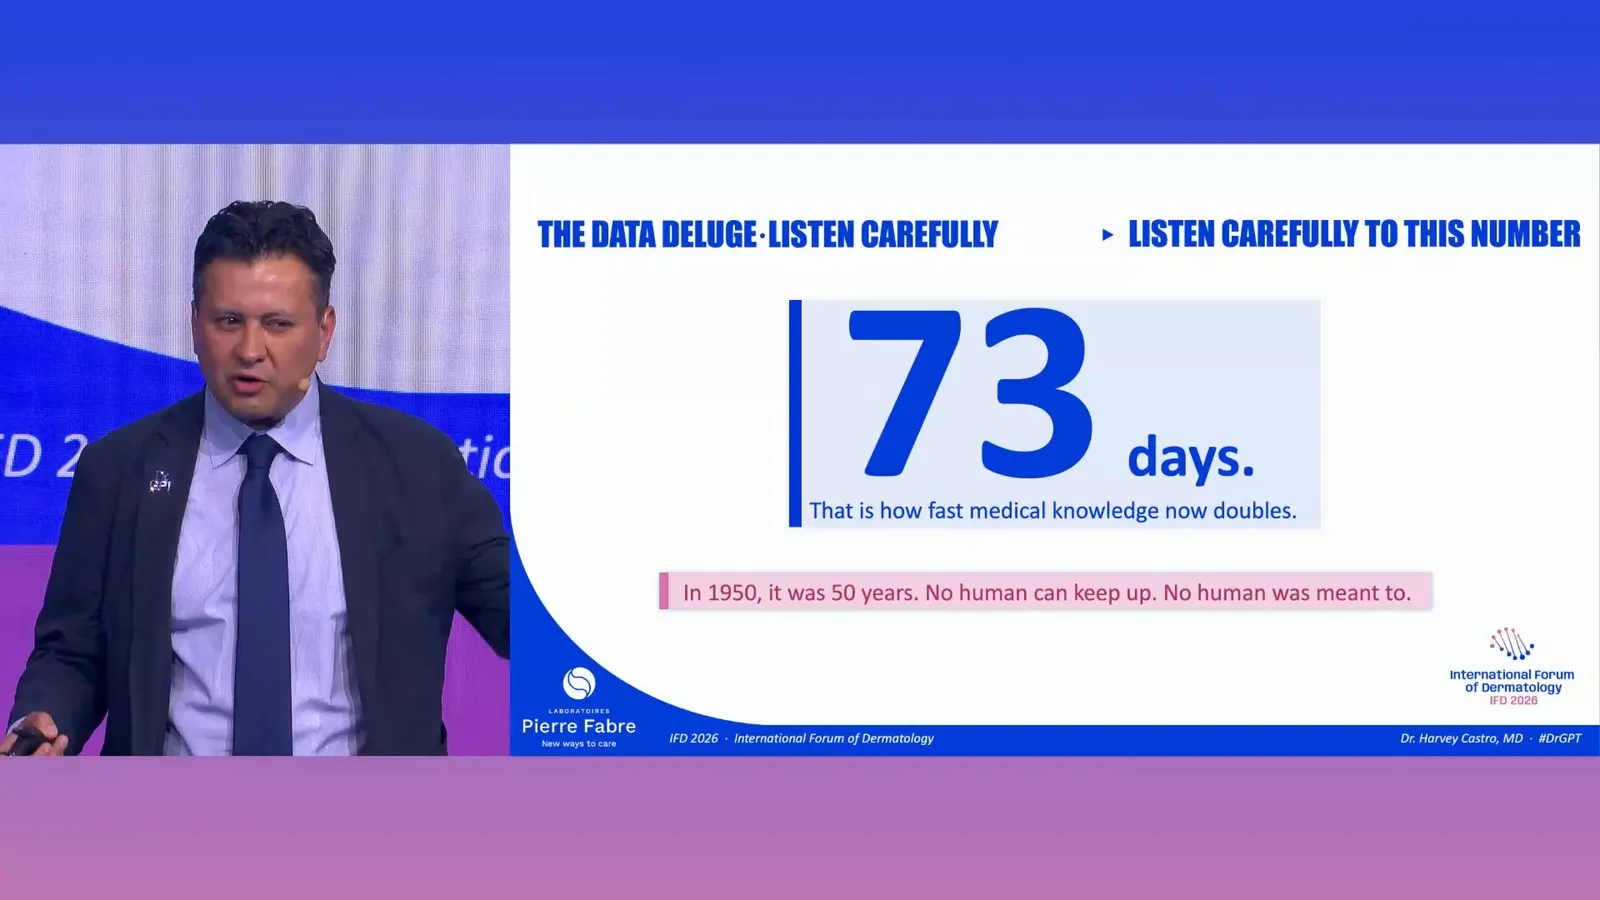 大字「73 天」,下面寫「這是現在醫學知識翻倍的速度」,粉紅色那一行:1950 年要 50 年,沒有人跟得上。
這個數字流傳很廣,源頭是 2011 年 Paul Densen 在美國臨床與氣候學會會刊(Transactions of the American Clinical and Climatological Association)的一篇文章:醫學知識翻倍的時間,1950 年估計是 50 年,1980 年 7 年,2010 年 3.5 年,「2020 年預計是 0.2 年,只有 73 天」。
那是十五年前對 2020 年的推估,原文沒有附上計算的出處。「知識」怎麼算、算的是論文篇數還是別的東西,也沒有交代。拿它來說明醫學走得很快可以,當成量測過的事實就不行。
Castro 醫師的主張寫在下一張投影片:AI 不是替代,是副駕駛。文書、模式辨識、資料整合交給 AI;同理心、判斷、醫病關係,留給醫師。他自己就用 AI 分析醫師同事看診時怎麼說話、怎麼坐、怎麼站,幫他們改善溝通。
95% 對 86%:同一場會議,原作者可能就坐在台下
回到開頭那張投影片。長條旁邊標的是「AI LESION CLASSIFIER (ISIC 2024)」,沒有列論文。ISIC 2024 是國際皮膚影像協作組織辦的演算法競賽,評分方式不是這種單一準確率,我對不上這組數字。
數字最接近的,是德國海德堡大學 Holger Haenssle 團隊 2018 年刊在 Annals of Oncology 的〈Man against machine〉。這篇的設計是:
- 從 300 張皮膚鏡照片裡,請兩位資深醫師挑出 100 張比較難判斷的,只有黑色素瘤和良性痣兩種
- 邀請 172 位國際皮膚鏡學會的醫師,58 位交回答案,來自 17 國,其中 30 位有五年以上皮膚鏡經驗
- 同一組照片也給 Google Inception v4 架構訓練的 AI 判讀
| 敏感度(抓到黑色素瘤的比例) | 特異度(良性痣判成良性的比例) | |
|---|---|---|
| AI,預設切點 0.5 | 95% | 63.8% |
| 58 位皮膚科醫師平均(只看皮膚鏡) | 86.6% | 71.3% |
| AI,拉到跟醫師同樣 86.6% 的敏感度 | 86.6% | 82.5% |
投影片的 95% 和 86%,最可能是第一欄的前兩格。問題在於:AI 用的切點比較寬,多抓到黑色素瘤,代價是多把良性痣判成可疑,特異度掉到 63.8%,比醫師還低。這兩個數字並排,就像拿一位寧可多切的醫師,跟一位比較保守的醫師比「誰抓到比較多」。
論文自己的主比較是第三列:在同樣的敏感度下,AI 多認對了一些良性痣,82.5% 對 71.3%,差距有統計意義;整條 ROC 曲線下面積 AI 0.86,醫師平均 0.79。AI 在這個考場裡確實贏了大多數醫師。86% 也是 58 位醫師的平均,不是某一位「專家」。
作者在討論裡自己寫了限制:讀片是人工情境,醫師不用承擔漏掉黑色素瘤的後果;測試集只有黑色素瘤和痣,沒有色素性基底細胞癌、脂漏性角化這些常見的混淆對象;其他膚色、族群的影像不夠。最後一條對台灣讀者特別要緊。
問答時間,主持人點名請「Haenssle 教授」發問,這場會議皮膚腫瘤場次的講者名單上也有 H. Haenssle 教授。他問三位講者:除了願景,各自最擔心的限制是什麼。
Haenssle 自己在皮膚腫瘤那一場,把這類 AI 從考場搬進門診:醫師參考 AI 的分數之後,良性痣少切了 19.2%;同一套 AI 換去看罕見皮膚腫瘤,曲線下面積掉到 0.634——〈AI 看皮膚癌準嗎?遇到罕見腫瘤只比亂猜好一點〉。
「95% 是跟誰比、在什麼條件下比」,站上追過幾次。猶他州讓 AI 開痘痘處方,門檻 95% 一致率,量的是公司自家醫師同不同意 AI,不是病人有沒有變好:〈猶他州讓 AI 自己開痘痘處方:95% 是跟誰比?〉。微軟的 AI 診斷 83.2% 對醫師 36.1%,對照組是不能找同事商量的基層醫師,病例全是純文字:〈微軟 AI 診斷登上 Science:先問 25.5 題才開單〉。
Castro 醫師下一張投影片講了一個故事:36 歲、兩個孩子的 Elena,肩上一顆差點被忽略的雀斑,遠距皮膚科 app 12 秒標出來,皮膚科醫師 12 分鐘確認,第一期黑色素瘤,比下次例行檢查早了 14 個月。投影片沒有標出處,配圖是影像素材,比較像是講者用來說明的情境故事。
mySUN:用「你會老幾歲」勸青少年擦防曬
第三位講者 Pellacani 教授一上台就說明,這是 Pierre Fabre 的專案。
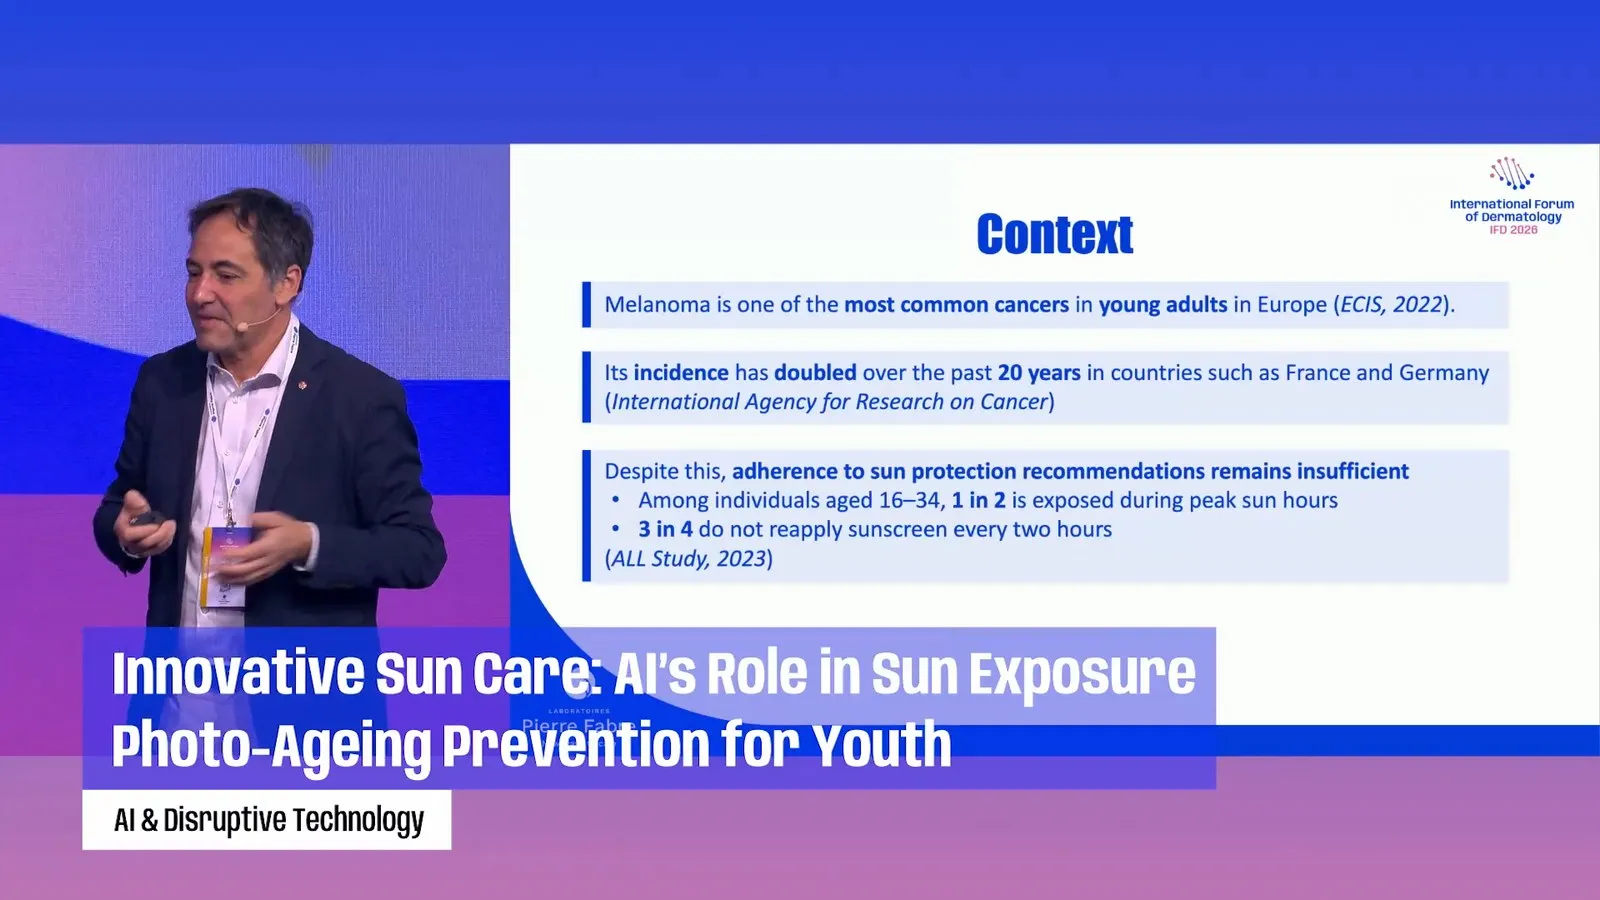 三段背景:黑色素瘤是歐洲年輕成人最常見的癌症之一;法、德等國發生率二十年來加倍;16 到 34 歲的人,每兩個有一個在日正當中曬太陽,每四個有三個不會每兩小時補擦(標註 ALL Study, 2023)。下方的字是重播畫面疊上的場次標題。
最後那兩個比例,參考文獻頁對應的是 2024 年 JEADV 一篇 20 國、50,552 人的線上問卷:47.96% 在上午 10 點到下午 4 點之間曬太陽,在戶外每 2 小時補擦一次防曬的只有 24.05%。摘要是全部年齡的數字;作者群裡有 Pierre Fabre 的研究人員。
他也引了一篇 2023 年的孟德爾隨機化研究:用基因預測的童年曬傷,跟黑色素瘤的勝算比 4.74(95% CI 1.31–17.19)。區間很寬,作者自己用的字是「suggestively significant」,提示性的顯著。
接下來是他的核心論點。他說菸害防制做了三十年,發現對青少年講「會得癌症」沒有用,他們覺得自己會活到永遠;最有效的訊息是皮膚科的那一句:抽菸會讓你變老。他提到一項法、西、德約 200 名學生的調查,光老化的說法對他們最有感。所以防曬也該換一套說法:少講皮膚癌,多講皺紋。
mySUN 是一個網頁應用程式,回答 7 題簡短問卷;模型用到的因子是膚型、曬太陽的多寡、有沒有擦防曬、年齡、性別、住的緯度。算出來的結果是:照這樣曬下去,10 年後你看起來會老幾歲。他舉的例子是一位不擦防曬、膚色淺的青少年,可能看起來老 15 歲。
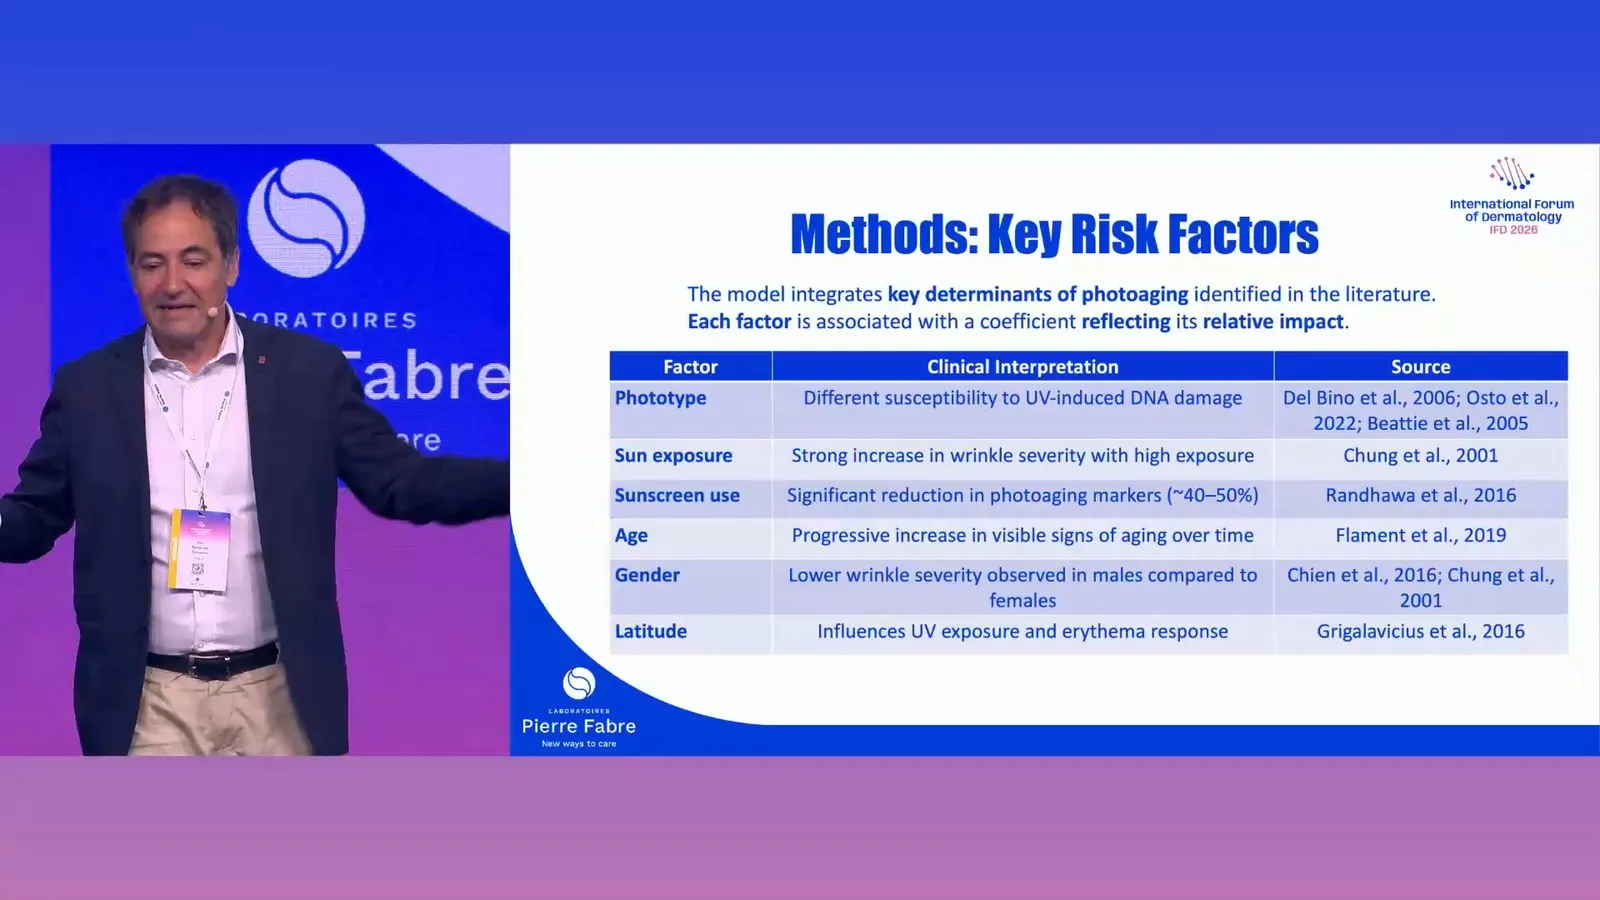 表格列出六個因子與文獻:膚型、曬太陽多寡、防曬使用(光老化指標顯著下降,約 40–50%)、年齡、性別(男性皺紋較輕)、緯度。
前一張投影片寫明,這是一個乘法模型:每個因子乘上一個從文獻挑出來的係數,相乘得到分數。它沒有拿一群人的照片去訓練,比較接近一張精心設計的計分表。叫它 AI 可以,但要知道它的準確度取決於那幾個係數抄得對不對、適不適用。
防曬那一格的「40–50%」,出處是 2016 年 Dermatologic Surgery 一篇研究:32 個人每天在臉上擦 SPF 30,擦滿 52 週,皮膚質地、清晰度、斑駁色素比一年前改善 40% 到 52%。第一作者來自嬌生(Johnson & Johnson)的皮膚研究中心。這篇沒有「不擦防曬」的對照組,是同一群人跟一年前的自己比;一年裡季節、保養習慣的變化,加上評分的醫師知道每個人都擦了防曬,都可能讓分數變好。
有對照組的證據要回到 2013 年 Annals of Internal Medicine 那篇澳洲 Nambour 的隨機試驗:903 位 55 歲以下的成人,隨機分成「天天擦防曬」和「想擦再擦」。4.5 年後,由不知道分組的評估者評估皮膚表面的微細紋路,天天擦那組的皮膚老化比對照組少 24%(相對勝算 0.76,95% CI 0.59–0.98)。作者自己寫了限制:有些結果資料缺漏,偵測中等效果的統計力有限。
24% 比 40–50% 小,但它是拿天天擦的人跟沒天天擦的人比出來的。這是把防曬寫進臨床建議時我會用的數字。
Pellacani 教授最後自己列了下一步:大規模研究、標準化流程、改善校準、臨床驗證。換句話說,這個工具目前還沒有證據顯示用過的青少年比較會擦防曬,也還沒驗證它預測的「老幾歲」準不準。模型的係數取自哪些族群的研究,套到台灣青少年身上準不準,也還沒有答案。
想讓青春期的孩子擦防曬,「會長皺紋、會長斑」可能比「會得皮膚癌」聽得進去,這個方向我在門診也有同感。但孩子的曬傷本身才是要避開的事:游泳、戶外運動、畢業旅行那幾天,擦夠量、記得補,比任何 app 的預測都實在。
痣在短時間內變大、顏色不均、邊緣不規則、出血或潰爛,不管有沒有 app 提醒,都要找皮膚科醫師看。
台下問的,都是落地的問題
這位教授問完限制,Zink 教授的回答很直接:在德國,最大的限制是資料安全。他們醫院有研究用的問診聊天機器人、乾癬診斷工具,到今天還是不能放進日常臨床流程。
Castro 醫師擔心的是兩件事。一是沒受過醫學訓練的網紅,加上深偽技術,十秒鐘就能模仿一位醫師的聲音與長相發文。二是在美國以外的一些地方,病人問完 AI 就直接去藥局買藥,中間沒有醫師。
有一位醫師問:病人先問過 AI 才來,如果我的判斷跟 AI 不一樣,以後要怎麼說服他?Zink 教授拿計算機比喻:先學會算數,才開始用計算機,最後是信任的問題;他更擔心的是,怎麼教出一代「從沒見過沒有 AI 的標準答案」的醫師。Castro 醫師的做法是把推理過程攤開給病人看,因為 AI 是黑盒子,病人看不到它怎麼想。
病人帶著 AI 的答案走進診間,站上那篇〈病人走進診間前,已經被四個 AI 看過〉整理過另一場皮膚科會議的做法,包括 AI 衛教一定要寫明「什麼情況下停下來,去看醫師」。
最後一個問題是去技能化:醫師依賴 AI 之後,大腦那一塊會不會退化?Castro 醫師舉了一個住院醫師訓練計畫的做法:第一年不准用 AI 寫病歷,逼自己動腦;第二年混著用;畢業時才全面使用。他說,沒學過的技能,你不會知道自己不會。
參考文獻
- Haenssle HA 等,Man against machine: diagnostic performance of a deep learning convolutional neural network for dermoscopic melanoma recognition in comparison to 58 dermatologists,Ann Oncol 2018;29(8):1836–1842,doi:10.1093/annonc/mdy166(PMID 29846502)
- Ayers JW 等,Comparing Physician and Artificial Intelligence Chatbot Responses to Patient Questions Posted to a Public Social Media Forum,JAMA Intern Med 2023;183(6):589–596,doi:10.1001/jamainternmed.2023.1838(PMID 37115527)
- Khasentino J 等,A personal health large language model for sleep and fitness coaching,Nat Med 2025;31(10):3394–3403,doi:10.1038/s41591-025-03888-0(PMID 40813712)
- Swanson K 等,The Virtual Lab of AI agents designs new SARS-CoV-2 nanobodies,Nature 2025;646(8085):716–723,doi:10.1038/s41586-025-09442-9(PMID 40730228)
- Densen P,Challenges and opportunities facing medical education,Trans Am Clin Climatol Assoc 2011;122:48–58(PMID 21686208)
- Lim HW 等,Sun exposure and protection habits: Self-reported attitudes, knowledge and behaviours,J Eur Acad Dermatol Venereol 2024;38(10):2024–2033,doi:10.1111/jdv.20080(PMID 38738687)
- Li Y 等,Childhood sunburn and risk of melanoma and non-melanoma skin cancer: a Mendelian randomization study,Environ Sci Pollut Res Int 2023;30(58):122011–122023,doi:10.1007/s11356-023-30535-3(PMID 37962759)
- Randhawa M 等,Daily Use of a Facial Broad Spectrum Sunscreen Over One-Year Significantly Improves Clinical Evaluation of Photoaging,Dermatol Surg 2016;42(12):1354–1361,doi:10.1097/DSS.0000000000000879(PMID 27749441)
- Hughes MC 等,Sunscreen and prevention of skin aging: a randomized trial,Ann Intern Med 2013;158(11):781–790,doi:10.7326/0003-4819-158-11-201306040-00002(PMID 23732711)
- Pierre Fabre,International Forum of Dermatology 2026 重播頁,https://pierrefabreformed.com/
en/ (2026-10-27 查閱)news/ pierre-fabre-ifd-international-forum-dermatology-2026
重要聲明
本文僅供衛生教育參考,不能取代專業醫師的診斷、治療或處方。實際用藥種類、強度與療程需由醫師依個別病況判斷。若症狀急速惡化、大面積起水泡、合併發燒或傷口化膿,請立即就醫。