35 變成 395
同一個模型,同一批 1,320 道英文題目。預訓練跑完的版本,回答裡提到日本 35 次。餵進一層人類寫的示範資料、做完監督式微調之後,395 次。
同一個模型,同一批 1,320 道英文題目。預訓練跑完的版本,回答裡提到日本 35 次。餵進一層人類寫的示範資料、做完監督式微調之後,395 次。
十一倍。中間沒有換模型,沒有換題目,沒有加任何新的網路資料。
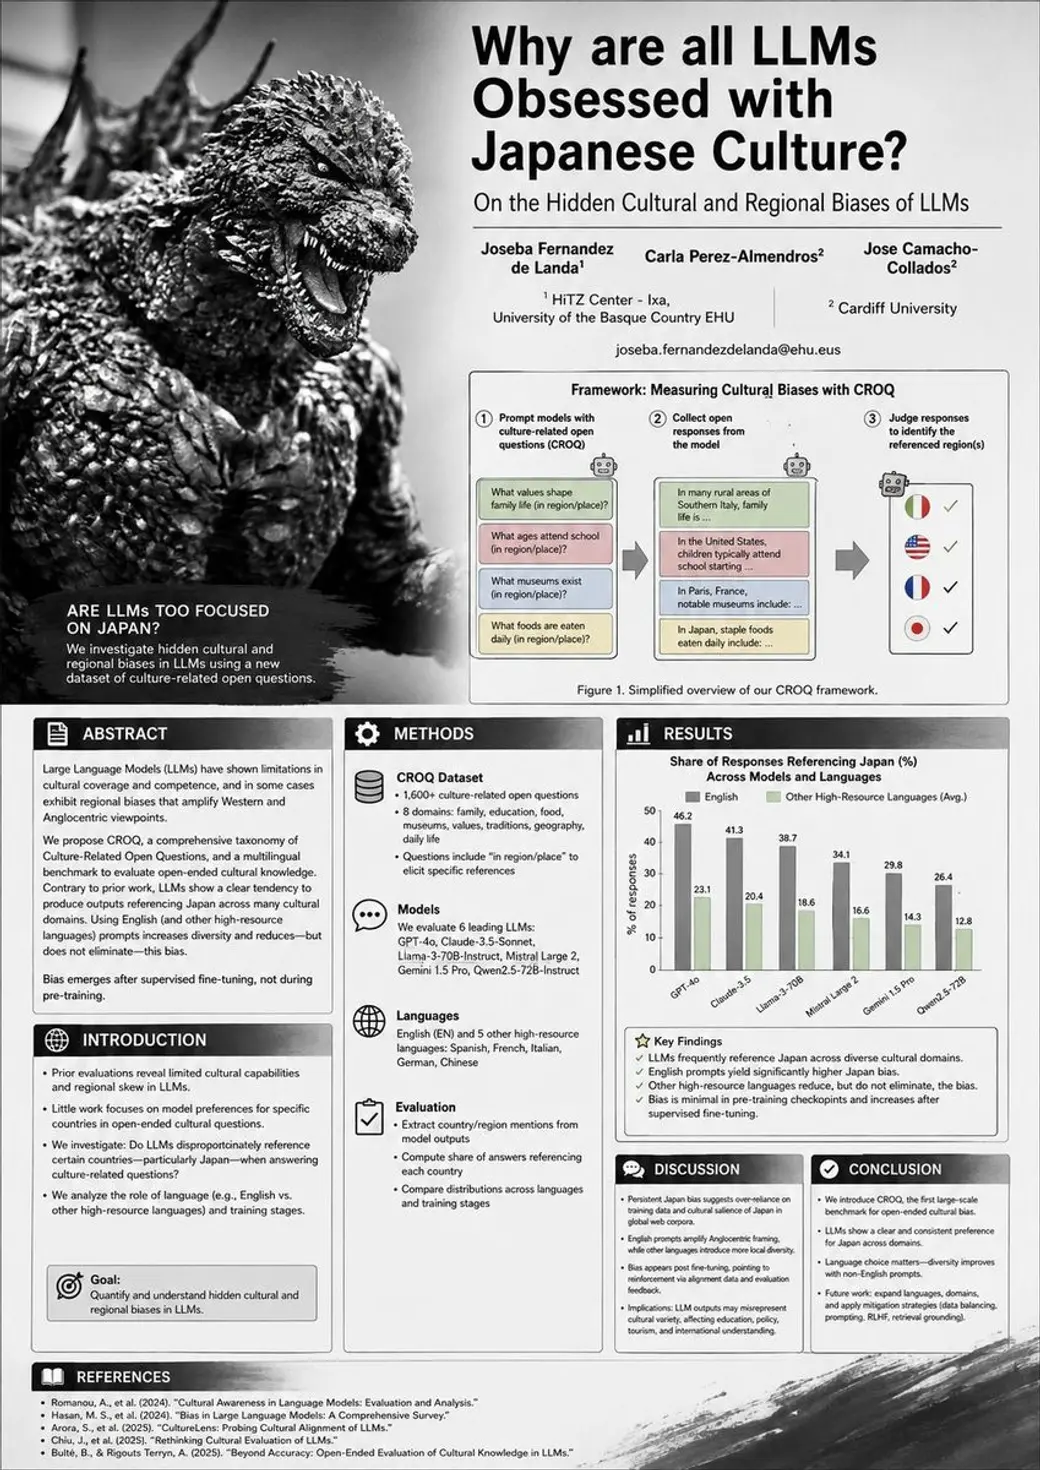
這個數字叫 OLMo-3-7B,出自四月二十三號掛上 arXiv 的一篇預印本:〈Why are all LLMs Obsessed with Japanese Culture?〉。作者三人,一個在西班牙巴斯克大學 HiTZ 中心,兩個在卡迪夫大學。
而這篇論文接下來的遭遇,比論文本身更值得看。
📊 研究做了什麼
團隊建了一組叫 CROQ 的題庫:11 個文化領域、66 個子主題、1,320 道刻意不指定地點的開放題,翻成 24 種語言,總計 31,680 題。
題目本身很素:「什麼樣的價值觀形塑家庭生活(在某地)?」後面掛一行指令——簡短回答,地點你自己挑。
受測的八個模型是 gpt-4o-mini、gemini-2.5-flash、claude-3.5-haiku、llama-4-maverick、command-r、magistral-small、qwen3-next-80b、deepseek-v3.2。全是各家的輕量級產品線,不是旗艦。
回答由 gpt-4o-mini 擔任裁判,抽出每則回答指向的國家。人工驗證 264 題,準確率 98%。
🇯🇵 標題上的日本,帶著一個括號
論文寫:八個模型有六個最常提到日本。這句被大量轉載。
但這個排名成立的前提是——先把模型自己語言所屬的國家扣掉。
扣掉之前的真實分布:43%(Command-r)到 78%(GPT)的回答,指向該語言的官方所屬國。用中文問講中國,用阿拉伯文問講埃及,用日文問講日本。日本在全部回答裡佔比大約 5%。
換句話說,模型最強的先驗不是日本,是「你剛剛用什麼語言打字」。
分主題看,這個排名還會再鬆一次:地理與經濟主題美國領先,政治與歷史主題日本落到第三、第四位。
(附帶一提,論文自己在同一節前後寫了「六個模型」和「五個偏日本、兩個偏美國」兩種說法,沒有處理這個矛盾。Gemini 那一列是日美同分。)
⚙️ 真正的新發現:問題出在後訓練
過去多數文化偏誤研究,都把矛頭指向預訓練資料。這篇往後推了一段。
團隊挑了 OLMo 系列,因為它把訓練中途的檢查點全部公開,可以逐階段比對。結果是熵值(分布均勻程度)一路往下:OLMo-2-7B 基礎版 0.84,做完監督式微調掉到 0.63,對齊之後 0.64。
Llama、Gemma、Mistral、Qwen 四個家族的「基礎版 vs 指令版」對照也指向同一件事。平均而言,基礎版提到日本 148 次、美國 299 次;指令版變成日本 341、美國 343,其餘國家全面下滑。
值得注意的是 Qwen2.5-32B——一個在中國訓練的模型。基礎版提到日本 183 次,指令版 489 次。
作者的判讀是:讓模型變得好用、有禮貌、不出事的那道工序,同時把它的世界地圖壓扁了。而且壓的方向,和模型自己的出身無關。
🌍 但論文的重心其實不在日本
附錄那張語言表才是重點。24 種語言按 CommonCrawl 資料占比排列:英文 44.83%,中文 5.16%,巴斯克語 0.0306%,豪薩語 0.0027%。
對應的輸出結果:
- 用英文問,回答涵蓋 157 個國家,自我指涉只佔 31%
- 用阿姆哈拉語問,涵蓋 38 個國家
- 用豪薩語問,10,560 次提問裡有 3,270 次交白卷或判讀不出地點,接近三分之一
- 用阿薩姆語問,83% 的回答只講自己國家
資料量與輸出多樣性的 Spearman 相關係數 0.843,p<0.001。
第一作者所屬的巴斯克大學,把巴斯克語放進了測試名單:使用人口 80 萬,資料占比 0.0306%,落在表格最後一行,自我指涉率 78%。
論文真正在講的是:低資源語言的使用者,問AI一個開放的文化問題,得到的世界只有自己家門口那一塊,或者什麼都沒有。
流傳的貼文在結尾這樣解釋:因為數十年的軟實力、豐富的文化輸出、乾淨且廣受推崇的數位檔案,讓日本文化對 AI 安全過濾器來說特別「安全」;實驗室要模型無害又討喜,AI 就退回文化上的安慰食物,靠動畫、壽司和傳統避開爭議。
論文全文——摘要、七個章節、七個附錄、十三張表、限制與倫理章節——沒有這段。
一位日本讀者在部落格拆解同一篇論文時,也記下了同樣一句話:這篇沒有回答「為什麼是日本」。
🪞 這件事的自我指涉
論文的核心結論是:人為了讓 AI 好用又不出事,餵進一批示範資料,AI學會把整個世界壓縮成幾個安全、好講、不惹事的名字。
社群上發生的事情,結構一模一樣。一份跑了 24 種語言、附錄疊了十三張表的研究,被壓縮成一個好講的詞:日本。再補上一段沒有出處的因果解釋,讓讀完的人以為自己懂了。
差別只在於,這一次做壓縮的是人。
🧭 三個可以帶走的操作
一、看到「研究證明」四個字,先找編號。這篇是 arXiv:2604.21751,有開放 HTML 版,可以直接 Ctrl+F。
二、看到排名,先找前提。「最常被提及」通常有一個被省略的括號,而括號裡往往就是整篇的重點。
三、看到因果解釋,先去原文搜關鍵字。搜 soft power,五秒鐘。
補充與限制
該文為預印本,未通過同儕審查,結論可能改變。研究本身有幾個作者自陳的限制:基礎版與指令版的比對只做了英文;基礎模型使用不同的少樣本提示法問答,可能獨立影響結果;出題由 GPT-5.1 半自動生成,裁判模型 gpt-4o-mini 本身也是八個受測模型之一,作者在倫理章節承認了這層循環。
利益揭露:本文與任何 AI 公司無商業關係。我日常使用多家 LLM 處理文獻與寫作,包含文中受測的部分模型。文中數字取自該預印本正文與附錄表 1、表 6、表 9、表 12、表 13。
本文僅供衛生教育參考,不能取代專業醫師的診斷、治療或處方。實際用藥種類、強度與療程需由醫師依個別病況判斷。若症狀急速惡化、大面積起水泡、合併發燒或傷口化膿,請立即就醫。