微軟 AI 診斷登上 Science:先問 25.5 題才開單
微軟的 AI 診斷真的贏醫師嗎?Science 研究:NEJM 難題準確率 83.2%,可查資料的第一線醫師 36.1%;但這是文字模擬,對照組不是專科醫師,15 位作者全是微軟員工。
本篇分成 8 段
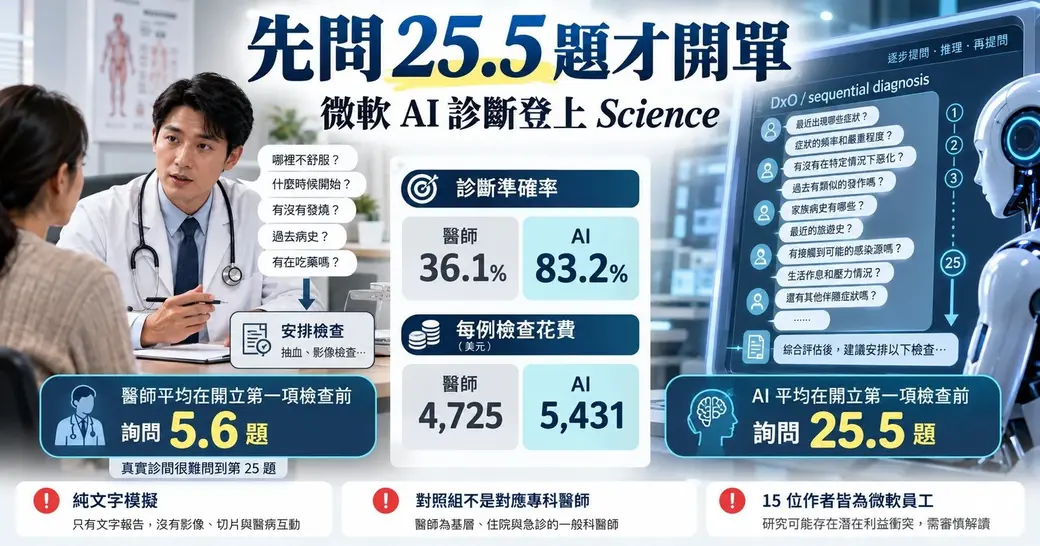
醫師平均問 5.6 個問題,就開出第一張檢查單。AI 平均問 25.5 個。
這兩個數字出自 10 月 22 日 Science 刊出的微軟團隊論文〈Sequential diagnosis with language models〉。研究把 304 個 NEJM 臨床病理討論會病例、325 個急診轉住院病例(MIMIC-IV-ED),拆成一來一往的診斷過程,讓醫師和 AI 從同一句開場白開始,各自決定下一步要問什麼、開什麼。
新聞標題拿走的是另一組數字:AI 83.2%,醫師 36.1%。這兩個數字都對,只是各自帶著條件。
在一個純文字的模擬看診裡,微軟的診斷系統 DxO(搭 GPT-5、不設預算)答對 NEJM 難題的 83.2%,可以查資料的第一線醫師平均 36.1%。代價是 AI 這一版每例的檢查花費 5,431 美元,比醫師的 4,725 美元還高;設了預算的版本降到 1,303 美元,準確率 79.6%。
對照組是單獨作答的基層、住院與急診醫師,不是對應的專科醫師;病例裡沒有影像、沒有病理切片,計分只看診斷對不對,不看治療與安全。15 位作者全是微軟員工。
模型一直在換代,這篇最能留下來的,是那把量 AI 的尺:SDBench。
把一次看診,拆成一來一往
開場只給一小段描述。論文附的範例是這樣一句:一位 29 歲女性因為喉嚨痛、扁桃腺周圍腫脹出血住院,用了抗生素症狀沒有退。
接下來由醫師或 AI 自己決定:再問一題病史、開一張檢查單,或直接下診斷。每項檢查依美國 CPT 價格累加,開得越多,帳單拉得越長。價格取自 Kaiser Permanente Washington 中央醫院公開的收費表。
AI 這端,Science 論文裡叫 DxO(Diagnostic Orchestrator),微軟對外的名字是 MAI-DxO。它在內部模擬一組分工不同的醫師互相辯論,每一步先算這項檢查值不值得開,最後再把幾次獨立推理的診斷彙整起來。DxO 不綁定某一顆模型,底下可以換成不同公司的語言模型。
這套考場裡有兩個不下場的角色。
Gatekeeper 守著病例原文,你問什麼它才答什麼,而且只給「臨床上問得到、驗得到」的資訊。碰到病例裡沒有記載的檢查,它會生成一個不指向任何答案的合成結果。理由是「問不到」本身就會洩題:如果某項檢查一問就說沒有資料,聰明的考生會從空白裡讀出線索。
Judge 負責改考卷。它拿診斷去對標準答案,用一份醫師寫的五級量表打分,4 分或 5 分算對,意思是:跟標準答案接近到「處置不會改變」。
DxO 那一組虛擬醫師,各自做什麼
Science 正文只寫 DxO「模擬一組角色互補的臨床專家」。2025 年 6 月的 preprint 把這組虛擬醫師列得比較細:
- Dr. Hypothesis:維持一份依機率排序的鑑別診斷,只留最可能的三個,每多一個發現就用貝氏方式更新機率
- Dr. Test-Chooser:每一輪最多挑三項檢查,挑的是最能把領先的幾個假設分開的那幾項
- Dr. Challenger:專門唱反調,找出可能的錨定偏誤、指出互相矛盾的證據,提出能推翻目前首選診斷的檢查
- Dr. Stewardship:管成本,診斷價值相同時主張用便宜的,否決貴而低產值的檢查
- Dr. Checklist:在背景做品管,確認檢查名稱有效、整組推理前後一致
以上是 preprint 版本的寫法,當時底下搭的是 o3。
83.2% 是不設預算的那一版
NEJM 病例(臨床病理討論會):
| 誰 | 準確率 | 平均每例檢查花費 |
|---|---|---|
| DxO(GPT-5),衝準確率的設定 | 84.5% | 8,945 美元 |
| DxO(GPT-5),不設預算 | 83.2% | 5,431 美元 |
| DxO(GPT-5),設預算 | 80.9% | 2,241 美元 |
| DxO(GPT-5),預算再收緊 | 79.6% | 1,303 美元 |
| 表現最好的單一醫師 | 51.8% | — |
| 醫師,可以查資料 | 36.1% | 4,725 美元 |
| 醫師,不能查資料 | 22.3% | 3,049 美元 |
急診病例(MIMIC-IV-ED):
| 誰 | 準確率 | 平均每例檢查花費 |
|---|---|---|
| DxO(GPT-5),不設預算 | 80.3% | 4,979 美元 |
| DxO(GPT-5),設預算 | 73.2% | 2,634 美元 |
| DxO(GPT-5),預算再收緊 | 69.5% | 2,037 美元 |
| 表現最好的單一醫師(40 例) | 62.5% | 3,332 美元 |
| 醫師,可以查資料 | 46.8% | 3,400 美元 |
急診這一組,醫師只做了可以查資料的版本。
計分方式前面說過:診斷跟標準答案接近到「處置不會改變」,就算對。
讀這兩張表要先知道一件事。NEJM 那一組,醫師作答的是 56 個在系統開發時刻意保留、沒有拿來調整的病例;2025 年的 preprint 寫明,AI 是在全部 304 例上算分。兩個數字並排看的時候,別把它讀成同一批病例上的比分。
醫師這一端的細節
- 參與的是在職的基層、住院與急性照護醫師,論文寫明包括內科專科醫師、急性照護與急診醫師
- NEJM 那 56 例:每位醫師平均做了 36.4 例(不能查資料)、34.8 例(可以查資料),合計 764 筆與 662 筆診斷
- 每例平均花 11.9 分鐘(不能查資料)、18.1 分鐘(可以查資料)
- 全程平均問 6.1 題、8.4 題,開 7.1 項、12.1 項檢查
- 可以查資料之後,問的題數、開的檢查、花的時間與費用都增加
- 表現最好的那位醫師 51.8%,論文寫他在準確率與花費上都被 DxO 超過
DxO 對不同模型的加成:論文拿多家公司、多種大小的商用模型,以最簡短的提示直接作答當基準,再套上 DxO 比較。平均下來,DxO 讓急診病例的準確率多 4.4 個百分點、NEJM 病例多 7.9 個百分點。
25.5 題,在這個模擬裡幾乎不用錢
醫師平均問 5.6 個問題,就開出第一張檢查單。DxO 平均問 25.5 個,在同一批病例上。
把這個畫面放進門診:病人剛坐下,手還搭在包包拉鍊上,對面已經問到第二十題,抽血單還沒印。真實診間很難這樣,候診椅上坐滿人,護理師在門口探頭。
但在這個模擬裡,問話跟開檢查的計價方式不一樣。問病史、做身體檢查,整包算進一次固定的看診費;preprint 寫得更清楚:一次看診 300 美元,連續問好幾題都算同一次,開出檢查單,這次看診才結束。抽一管血、照一張片子,則照 CPT 價格另外累加。
所以多問幾題幾乎不加錢。AI 照規則算,結論是先把病史問乾淨。
這樣問,也真的問出東西。論文分析錯誤時發現,DxO 贏過同一顆模型直接作答的地方,集中在靠問病史才問得出來的診斷,像少見的暴露、旅行相關的感染。preprint 舉過一個例子:一位因酒精戒斷住院的病人,偷喝了乾洗手液。直接作答的 o3 卡在抗生素中毒,開了腦部 MRI 和腦波,最後答錯,花了 3,431 美元。同一顆 o3 套上 DxO,第一輪就依發作的時間點提出:要考慮住院期間接觸到的毒物。那組虛擬醫師在開任何檢查之前,先問了有沒有喝乾洗手液;病人承認了,再做一組有針對性的毒性醇類檢驗,丙酮升高,答對,總共 795 美元。
你上週門診開單最快的那位病人,回頭看,多問兩題,那張單還需要開嗎?
要打折的地方
準確率 83.2% 的不設預算版本,每例花費比查資料的醫師還高:5,431 美元對 4,725 美元。便宜的版本掉到 79.6%,仍然領先,但論文摘要只寫了 83.2% 這一個數字,新聞標題跟著摘要走。
對照組是單獨作答的基層、住院與急診醫師。作者自己寫明,這些比較不代表勝過專科醫師、多科團隊或真實臨床,也預期面對對應的專科醫師時,差距會縮小。NEJM 病例本來就是因為有教學價值才被選上,常附著專科醫師的反思與結論;作者自己寫,DxO 在這組病例上大幅領先,或許不令人意外。
病例也都是「有病」的病例。NEJM 偏向難診斷的個案,急診那組是已經住院的病人,兩組都沒有健康或良性的就診,病例組成跟日常門診差很遠。
模擬拿掉了病史講不清楚、病人忘了說、紀錄缺漏、醫病互動、長期追蹤;影像、波形、病理切片也沒放進來。醫師和 AI 對話的對象,是一個用文字回答的 Gatekeeper,不是一位會停頓、會改口的病人。
皮膚科的第一步是看。拿皮膚鏡貼上一顆痣、側光照一片斑,這一步本研究完全沒測。
計分只看疾病診斷對不對,不評治療恰不恰當、安不安全。檢查費用用的是美國的標準價格,抓不到等報告要幾天、檢查有多侵入、病人有多不舒服。
15 位作者全是微軟員工,持有公司股票;其中 8 位掛名微軟提出的一件美國專利申請(19/722,651),內容是序列診斷的自動評估框架。論文寫明,這些研究沒有取得微軟以外的任何經費。
這篇量的是:在資訊乾淨、只有文字、病人一定有病的考場裡,誰比較會問、比較會下診斷。它沒有量病人有沒有因此變好,也沒有量 AI 的建議放進真實診間之後,醫師會不會被帶偏。想知道這些,要等前瞻性研究。
論文印出來那天,模型已經換代
preprint 在 2025 年 6 月 27 日上線,當時用的是 o3。摘要寫的 80%,是設預算的版本(79.9%);同一篇 preprint 裡,不設預算 81.9%,衝準確率的版本 85.5%。那時參加的醫師是 21 位,一律不准查資料,平均 19.9%。這幾個數字跟 Science 的 83.2% 不是同一個版本,不能直接並排比較。
從 preprint 到 Science 收稿,隔了九個多月。這段時間加進 325 個急診病例,主模型從 o3 換成 GPT-5。Science 收稿日是 2026 年 4 月 4 日,8 月 10 日接受,10 月 22 日印出;收稿到印出約六個半月。從 preprint 算起,一年三個多月。
作者也有追:主結果換成 GPT-5,發表前又拿 GPT-5.5 把整套評估重跑一次,prompt 和編排都沒動。DxO 相對同一顆模型直接作答的優勢,反而變大。DxO 最早開發時,最強的模型還是 GPT-4.1。即使這樣,期刊印出來時,OpenAI 已經在 9 月 3 日推出 GPT-6 Astra。
三期藥物試驗跑三年,第一位受試者和最後一位吞下的藥錠,裡面是同一個分子。AI 研究的「藥」在試驗進行中改版兩三次,期刊審查的節奏卻照前者設計。
SDBench 這把尺,誰拿得到
所以這篇我會把價值放在 SDBench 這把尺。Gatekeeper 碰到病例沒記載的檢查,給一個中性的合成結果,避免「問不到」本身洩題;Judge 用「處置會不會改變」計分;每張檢查單都算錢。這套量法已在 GitHub 以 MIT 授權公開,研究者取得病例授權後,可以把新模型放進同一把尺。
83.2% 是某顆模型在某天的讀數,像耳溫槍「嗶」一聲跳出來的數字,下週再量就不同了。
尺公開了,量的東西還有門檻。公開的是 Gatekeeper、Judge、計價程式和一個基準作答程式;DxO 編排器本身不在裡面。NEJM 病例要另外向 NEJM Group 申請授權,限非商業研究使用;急診病例要通過 PhysioNet 的資格認證。程式庫裡只附了 5 個合成病例,而且註明不能拿來報告診斷準確率。
反過來看,新模型沒經過同一套流程驗證,不能直接假設它一樣準、一樣安全。升級後某類病例退步,這篇沒有資料能回答。
GitHub 上的 science 設定
程式庫 microsoft/sdbench 在 2026 年 10 月 19 日建立,授權為 MIT(Copyright Microsoft Corporation)。README 裡有一組名為 science 的設定,說明是「同儕審查的 Science 論文所用的設定」,要搭配基準作答程式使用。
- NEJM 病例:Gatekeeper 用 o4-mini,Judge 用 GPT-5
- 急診病例:Gatekeeper 與 Judge 都用 GPT-5
- 每例最多 70 回合
計價預設讀 Kaiser Permanente Washington 中央醫院的公開收費表,也可以換成其他醫院的收費表。
接下來:讓真實病人直接跟系統對話
微軟宣布將和波士頓 Beth Israel Deaconess 醫學中心合作,做一項前瞻性研究:讓真實病人直接跟系統對話,再拿醫師的獨立判斷比對。收案期間模型大概又會換版,他們選擇鎖定版本,還是邊跑邊更新並逐次記錄,值得追。
病人直接跟 AI 對話這件事,其實早就在發生。〈病人走進診間前,已經被四個 AI 看過〉那場皮膚科會議談的就是:病人推開診間的門之前,已經問過 Google、Gemini、ChatGPT。那篇也談到 AI 一定要有「停止條件」;SDBench 的 Judge 只問診斷對不對,什麼時候該停下來交給醫師,這一題它沒有考。
「準確率」量的是哪一步,站上另一篇也追過。猶他州讓 AI 開痘痘處方,門檻是 95% 一致率,量的是公司自家醫師同不同意 AI 選的藥,病人擦了之後有沒有變好,協議裡沒有任何比較——〈猶他州讓 AI 自己開痘痘處方:95% 是跟誰比?〉。這篇的 83.2% 也一樣,量的是診斷那一步,不是病人那一端。
這篇論文開頭批評的,是把整個病例一次塞給模型的靜態考題,說它可能高估 AI 的診斷能力。標準考試看不出問題,另一篇 Nature 研究給過一個例子:把語言模型訓練得更溫暖之後,一般能力測驗上看起來差不多,錯誤率卻增加了 10 到 30 個百分點——〈把AI訓練成暖男之後,它開始不敢說真話了〉。兩篇放在一起讀,會比較知道「考得好」離「在診間用得好」還有多遠。
參考文獻
- Nori H 等,Sequential diagnosis with language models,Science 2026;394(6822):423–428,doi:10.1126/science.aeh7930
- Nori H 等,Sequential Diagnosis with Language Models,arXiv:2506.22405(preprint,v1 2025-06-27,v2 2025-07-02),https://arxiv.org/
abs/ 2506.22405 - Microsoft,SDBench(GitHub 程式庫,MIT 授權),https://github.com/
microsoft/ (2026-10-23 查閱)sdbench - Microsoft AI 官方部落格(2026-10-22,宣布與 Beth Israel Deaconess 醫學中心合作),https://microsoft.ai/
news/ (2026-10-23 查閱)building-medical-superintelligence/ - OpenAI,API changelog(GPT-5.5 2026-04-24、GPT-6 Astra 2026-09-03 推出紀錄),https://developers.openai.com/
api/ (2026-10-23 查閱)docs/ changelog
重要聲明
本文僅供衛生教育參考,不能取代專業醫師的診斷、治療或處方。實際用藥種類、強度與療程需由醫師依個別病況判斷。若症狀急速惡化、大面積起水泡、合併發燒或傷口化膿,請立即就醫。