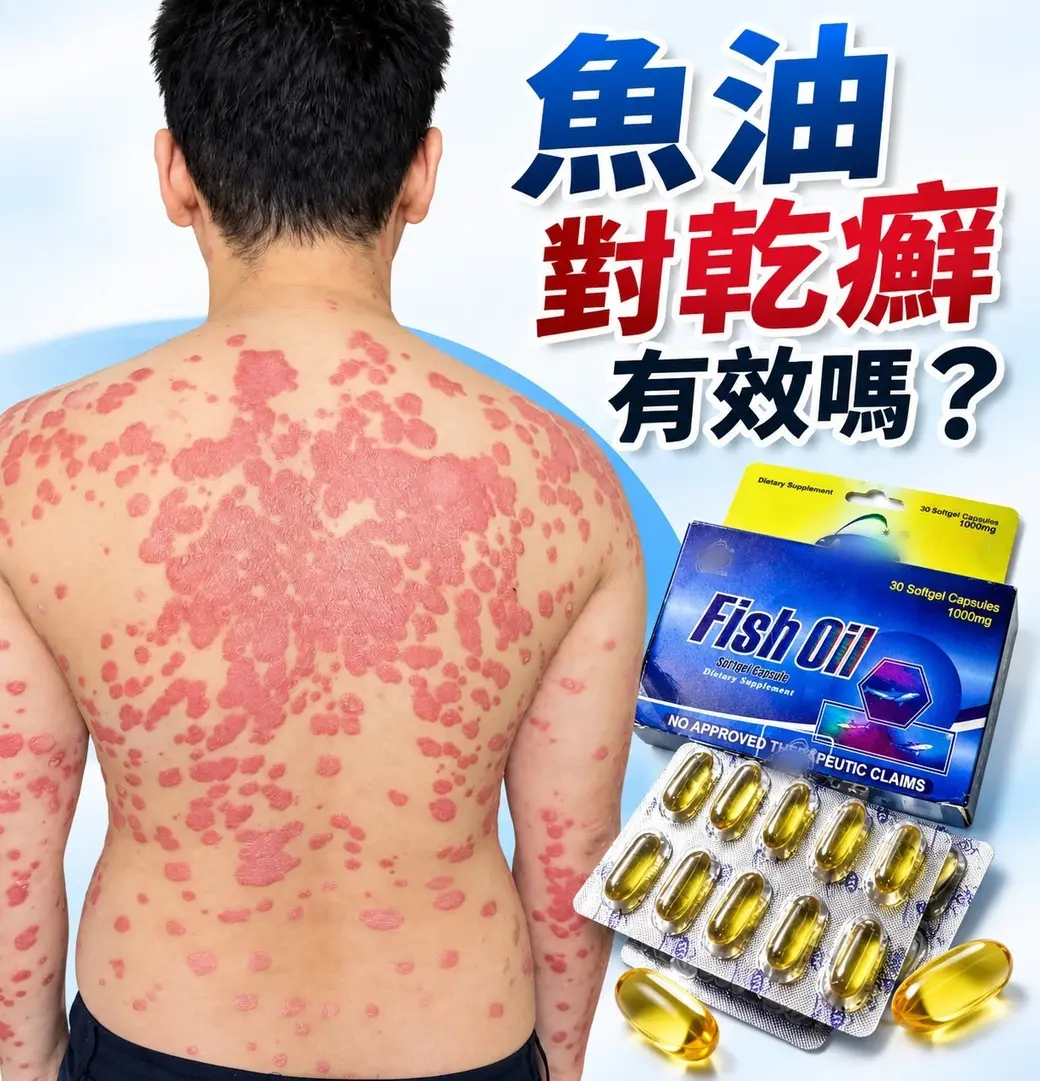
魚油對乾癬有效嗎?337 人說沒效,確定性最低
吃魚油能讓乾癬變好嗎?三個隨機試驗、337 人的答案是沒有差別(PASI 平均差 −0.28)。但用 Core GRADE 評完,連「沒效」這句話的確定性也只有最低一級。
本篇分成 9 段
藥妝店的保健食品架上,魚油那一排通常是最長的一排。盒子上印著「魚油」「深海魚油」「高濃度 EPA」,標價從三百到三千。
如果你有乾癬,你大概問過或想過這句話:那個可以吃嗎?
網路上的答案分成兩派。一派說魚油抗發炎,對乾癬有幫助;一派說研究做過了,沒效。這篇要講的是第三件事——那個「沒效」,我們有幾分把握。
三十年來,總共有三個隨機試驗、337 個人,拿魚油去試乾癬。把三個併起來算,魚油沒有讓乾癬變好。
但這個「沒有」的把握程度,被評成最低的一級。原因是人數太少,算出來的可能範圍寬到兩頭剛好相反:一頭說魚油真的有用,另一頭說魚油讓乾癬變嚴重。
所以現在能講的最誠實的一句話是:沒有人能告訴你魚油對乾癬有沒有用,而在這種情況下,把治療的期待放在魚油上,你等的會是一個沒有人算得出來的東西。
這是一篇教學文,不是新的研究,也沒有收任何病人。它教的是「怎麼給一個結論打把握分數」,然後拿魚油那份資料當範例示範一遍。
作者是邵世宜、郭亮增、黃仁達、賴珮君、張凱程、紀景琪六位,分屬基隆長庚醫院藥劑部、成功大學藥學系暨臨床藥學與藥物科技研究所、桃園聯新國際醫院運動醫學科、成大醫院外科、成大醫院教學中心、林口長庚醫院藥劑部。通訊作者紀景琪是林口長庚醫院皮膚科教授,同時在長庚大學醫學院醫學系。
刊在《Dermatologica Sinica》2026 年第 44 卷第 3 期,207 到 211 頁,2026 年 9 月 18 日上線。
還有一層關係要說明白:範例用的那篇魚油統合分析,通訊作者也是那篇的作者之一。 拿自己的舊作當教材不算利益衝突,但讀的人應該知道。
三十年前,有人真的把這件事拿去做實驗
先說為什麼會有人想到魚油。
魚油裡的 omega-3 脂肪酸——EPA 與 DHA——能壓低前列腺素 E2 這一類會推動發炎的物質。乾癬是一個發炎性的皮膚病。既然一邊會發炎、另一邊能壓發炎,這個念頭就成立了。站上寫過一篇營養與皮膚的回顧導讀,那條機轉線在裡面寫得比較完整,順便可以看到同一排膠囊裡其他幾顆的證據到哪裡為止:〈早餐旁那排膠囊,哪幾顆真的走得到你臉上?〉。如果你想知道「魚油抗發炎」這句話從哪裡來,先看那一篇;這一篇要處理的是它有沒有真的做出來。
念頭之後,是三次實驗。
1993 年,《新英格蘭醫學期刊》。 Søyland 的團隊給乾癬病人吃極長鏈 omega-3 脂肪酸的飲食補充。三個試驗裡,只有這一個登在《新英格蘭》。
1998 年,《美國皮膚科醫學會期刊》。 Mayser 的團隊做的是多中心、雙盲、安慰劑對照,收的是慢性斑塊型乾癬。他們給的是靜脈輸注的 omega-3 脂肪乳劑——病人躺在醫院裡打點滴,沒有人自己去藥局買膠囊。
2018 年,《Scandinavian Journal of Rheumatology》。 Kristensen 的團隊,隨機、雙盲、安慰劑對照,收的是乾癬性關節炎的病人,看的是發炎指標和止痛藥的用量。這是三個裡面人數最多的一個。
三個試驗散在 25 年之間,劑型不一樣,收的病人也不一樣。2019 年有人把它們併起來算了一次統合分析,量的是同一把尺——PASI,乾癬面積與嚴重度指數,原文說它是評估乾癬嚴重度的黃金標準。
三個加起來 337 人。合併結果:
兩組的 PASI 平均差 −0.28,95% 信賴區間 −1.74 到 1.19。
這兩串數字要先翻成人話。
「平均差 −0.28」的意思是:吃魚油那邊的 PASI 分數比對照那邊低了 0.28 分。負號代表魚油那邊好一點。而 0.28 分小到什麼程度?原文自己把「−1.15 到 1.15」這一段畫成「臨床上無關緊要」的範圍,0.28 就落在裡面。
「95% 信賴區間 −1.74 到 1.19」的意思是:真正的答案很可能落在這一段裡面,但這一段有多寬,就是我們有多不確定。 這一段從 −1.74 伸到 1.19,橫跨了 0。跨過 0,就是「沒有差別」也在可能範圍裡。
到這裡為止,故事是「有人試過,沒做出來」。接下來才是這篇教學文真正要講的事。
同樣一句「有效」,為什麼有的可以信、有的不能信
一句話講完了,你怎麼知道要不要相信它。
這個問題在 2004 年被正式處理過一次。那一年《BMJ》登出 GRADE 這套方法,把「證據的確定性」變成可以一級一級評出來的東西。二十多年後,採用它的組織超過 110 個——世界衛生組織、美國疾病管制與預防中心、英國國民保健署、Cochrane 合作組織,還有 UpToDate、DynaMed 這些醫師每天在查的臨床工具。
你在診間聽到的那句「這個有證據」或「這個沒有證據」,背後多半經過類似的一套判斷。
GRADE 這五個字母,一個一個拆開就是它在做的事。 全名是 Grading of Recommendations Assessment, Development and Evaluation:
| 字母 | 原文 | 中文 | 它負責的事 |
|---|---|---|---|
| G | Grading | 分級 | 把「這句話有幾分把握」評成一個等級,而不是只說有或沒有 |
| R | Recommendations | 建議 | 評的最後是要拿來給建議的——醫師該不該建議你做這件事 |
| A | Assessment | 評估 | 先看證據本身:研究怎麼做的、人數夠不夠、結果穩不穩 |
| D | Development | 制定 | 再把評估的結果,做成一條寫得出來的建議 |
| E | Evaluation | 評價 | 最後回頭檢查這條建議站不站得住,日後有新證據再重評 |
合起來就是一句話:把建議的證據分級、評估、制定出來,再回頭評價一次。 它不是在判斷「這個治療好不好」,是在判斷「支持這個說法的證據,有多值得你相信」。
問題是 GRADE 自己長歪了。指引一篇一篇加,愈來愈專門、愈來愈零碎,最後變成一套「理論上很完整、實際上很難下手」的東西。所以 2025 年《BMJ》又推出一個簡化版,叫 Core GRADE,一次七篇論文,把流程收回到可以照著做的程度。這篇教學文要濃縮的就是那七篇。
它的骨架簡單到可以一段講完:
- 從隨機試驗來的結果,起始分數是 High(高)。從觀察性研究來的,起始分數是 Low(低)。
- 一共四級:High(高)、Moderate(中等)、Low(低)、Very low(非常低)。
- 有五個面向會讓分數往下掉。每一個面向判成「不嚴重」到「非常嚴重」,對應降 0 到 2 級,極少數情況降 3 級。
- 有兩個面向會讓分數往上升,而且只適用於觀察性研究。隨機試驗已經從最高分起算,沒得再升。
用個比喻:GRADE 在做的事,是在一句話後面標上「這句話有幾分把握」。同樣是「沒有效」三個字,一句出自十萬人的大型試驗,一句出自三個小試驗、總共三百多人——兩句話長得一模一樣,可信度差很多。GRADE 就是把那個差別寫出來。
五個問句,一個一個問魚油
五個面向聽起來很學術,其實就是五個問句。原文把它們一個一個套在魚油那份資料上,走完一次判斷。跟著走一遍,你以後看到任何一篇研究都能自己問。
第一個問題:這三個試驗,做的時候有沒有哪裡容易出錯?
這一格叫偏誤風險。
答案是:三個試驗全部被評為高偏誤風險。問題出在三個地方——三篇都沒有把「結果是怎麼量的」講清楚;Soyland 1993 可能挑了好看的結果才報告;Kristensen 2018 用的是 per-protocol 分析,也就是只算「完整照著吃完」的那群人。
照直覺,三個全部高風險,這一格就該扣分。但原文沒有扣,理由值得看一遍,因為它反直覺。
Core GRADE 在這一格真正要問的,是偏誤會把答案往哪一邊推。上面那三個問題,理論上都會讓魚油看起來比實際上更有效。而合併起來的結果是沒有效。偏誤一直往「有效」那邊推,結果還是推不過去——那麼偏誤就不太可能改變這個結論。
這一格:不降級。
第二個問題:這三個試驗找的人、給的東西、量的東西,跟我想問的是同一件嗎?
這一格叫間接性。
舉個極端的例子就懂了:如果你想知道「擦這個藥能不能讓皺紋變少」,而研究量的是「皮膚裡某個蛋白質有沒有增加」,那就對不上——蛋白質是替代品,不是皺紋。這種情況 Core GRADE 要求直接降 2 級。
魚油這一格沒有這個問題。三個試驗收的人、用的魚油、比的對照,跟「魚油對乾癬有沒有用」這個問題對得上,而量的 PASI 是評估乾癬嚴重度的黃金標準,不是替代品。
這一格:不降級。
第三個問題:人數夠嗎?算出來的可能範圍有多寬?
這一格叫不精確。整篇的關鍵在這裡。
判斷前要先畫一條線,決定「差多少才算有意義」。這條線的名字是 MID(最小重要差異)——至少要差到這麼多,病人才感覺得出來。
原文畫的線是 ±1.15。怎麼來的?依據是「PASI 下降 50% 與生活品質的有意義改善相關」,再用人數最多的那個試驗(Kristensen 2018)的基線 PASI 值換算出來。
線畫好,把魚油的結果放上去。想像一條橫線,中間標 0,左右各標一個 1.15 的界線:
- 魚油的那個點落在 −0.28,離中間很近,在兩條界線之間。
- 但那個點的兩邊各拉出一條鬚,左端到 −1.74,右端到 1.19。兩端都越過了界線。
- 左端那一頭的意思是:魚油真的有臨床上重要的好處。右端那一頭的意思是:魚油讓乾癬變得臨床上重要地更糟。
一段範圍同時容得下這兩個完全相反的結論,就等於沒有回答問題。
這一格:降 2 級。
第四個問題:三個試驗有沒有互相打架?
這一格叫不一致性。
原文先講清楚以前的做法錯在哪:過去很多人用一個叫 I² 的統計值高低來判斷研究之間一致不一致,而這在很多情況下會誤導。Core GRADE 改成看各個研究的答案有沒有落在那條 MID 線的同一側。
三個試驗的信賴區間彼此有重疊,但點估計值差很多。拿去對 1.15 這條線,結果是:只有 Mayser 1998 那一個超過線(−3.70),另外兩個沒有。 三個之中有一個跟另外兩個講的不是同一件事。
這一格:降 1 級。
(這個判斷跟原文自己寫的規則有張力,下面會回來處理。)
第五個問題:有沒有做完了、結果不好看、就沒發表的試驗?
這一格叫發表偏誤。它問的是一件很實際的事:如果十個試驗做完,只有結果漂亮的三個被登出來,你看到的那三個就會騙你。
Core GRADE 的第一關是問:納入的研究是不是大部分都又小、又是廠商出錢做的?魚油這三個都不是業界贊助。
第二關是問能不能用統計方法檢查。這需要至少 10 個研究才做得動,這裡只有 3 個,檢查不了。第三關是去試驗註冊平台翻有沒有登記了卻沒發表的試驗——沒有找到。
原文老實寫了:發表偏誤沒辦法排除。但既然找不到證據,就不扣分。
這一格:不降級。
五格加起來:從最高掉到最低
| 面向 | 判斷 | 理由 |
|---|---|---|
| 起始等級 | High(高) | 來自隨機試驗 |
| 偏誤風險 | 不降級 | 三篇全部高偏誤風險,但偏誤的方向不影響結論 |
| 間接性 | 不降級 | 三篇的 PICO 與回顧問題一致,PASI 是黃金標準 |
| 不精確 | 降 2 級 | 信賴區間兩端都超過 MID,同時包含重要好處與重要壞處 |
| 不一致性 | 降 1 級 | 三篇中有一篇(Mayser 1998,點估計 −3.70)超過 MID |
| 發表偏誤 | 不降級 | 三篇皆非業界贊助,試驗註冊平台上沒找到未發表研究 |
| 兩個升級面向 | 不適用 | 只用於觀察性研究,這三篇都是隨機試驗 |
| 最終等級 | Very low(非常低) | 從 High 降三級 |
高,減二,減一,落到非常低。這就是「連『沒效』都不確定」那句話的算法。
那條 1.15 的線,是自己畫的
回到那條 MID。
信賴區間的上界是 1.19,門檻是 1.15。只超過 0.04。
數學上這個判斷沒有錯。但它完全靠那條線站著——如果 MID 訂成 1.20,這一格就完全不必降級,最終等級會從非常低變成低。而原文對這條線的推導只有一句話,沒有交代為什麼「PASI 下降 50%」這個相對降幅可以換算成 1.15 這個絕對值。
原文自己在「實務考量」那一節也承認了這件事:Core GRADE 雖然給了結構化的流程,主觀性仍然存在,不同的人評可能評出不同結果。它的建議是正式訓練、用明確準則做校準練習、至少兩個人獨立評。
那個 1.19 對 1.15 的擦邊,就是這句話最好的例子。
五個面向的完整判準,以及兩個升級面向
一、偏誤風險(RoB)
工具:平行分組隨機試驗用 Cochrane RoB 2 或 ROBUST-RCT;非隨機介入研究(如世代研究)用 ROBINS-I 修訂第 2 版。
關鍵原則是要在「結果層級」評,不是在「研究層級」評。同一個研究裡,不同的結果指標偏誤風險可能完全不同——例如手術對上標準照護的試驗沒辦法盲,那麼「病人自述滿意度」這種主觀結果的偏誤風險,遠高於實驗室確認的生物標記或死亡率這種客觀結果。
| 情況 | 做法 |
|---|---|
| 高偏誤風險的研究主導證據(權重 >65%,或 ≥55% 表示可能主導) | 先判斷偏誤的方向 |
| └ 偏誤有可能解釋掉看到的效果、或解釋掉看不到效果(高估或低估真實效果) | 全部納入,但降級 |
| └ 有效果而偏誤只會讓效果變小;或沒效果而偏誤只會讓效果變大 | 全部納入,不降級 |
| 高偏誤風險不主導,且低偏誤風險研究有相當份量(權重 ≥35% 或 ≥45%) | 比較高、低偏誤風險研究的效果估計值 |
| └ 兩者差很多 | 只納入低偏誤風險研究,不降級 |
| └ 兩者沒有明顯差異 | 全部納入,不降級 |
魚油那三個試驗全部高偏誤風險,等於 100% 權重,遠超過 >65% 的主導門檻,所以照規則要先判方向——偏誤會高估效果,而結果是沒有效果,符合「沒看到效果、而偏誤只會讓效果變大 → 不降級」這一條。
二、間接性(indirectness)
當臨床問題的 PICO(族群、介入、對照、結果)與納入研究對不上時就有間接性:族群的年齡差異、時代變遷、疾病特性不同;介入或對照的強度與持續時間不同,或用了不理想的對照;結果的追蹤時間不同,或依賴替代指標。
替代指標一律降 2 級。
三、不精確(imprecision)
第一步決定門檻是什麼:想知道效果臨床上重不重要,用 MID;想知道有沒有任何真實效果(好或壞),用虛無值。
第二步把效果表示成絕對尺度(平均差、風險差),並以點估計值定出確定性的標的。MID 可以用既有的公認值(疼痛、功能、生活品質這類病人回報指標常有),或作者依文獻與臨床經驗自訂。二元結果要把相對風險套到適當的基線風險上,換算成絕對風險差及其 95% 信賴區間。
第三步看信賴區間有沒有跨過門檻:
| 情況 | 做法 |
|---|---|
| CI 跨過門檻 | 降 1 級 |
| CI 橫跨兩個門檻(同時包含重要好處與重要壞處) | 考慮降 2 級 |
| CI 沒有跨過門檻,效果為中等 | 不降級 |
| CI 沒跨過門檻,但效果很大 | 進入最適訊息量(OIS)流程 |
OIS 流程:連續型結果,總樣本數達到或超過 OIS(經驗法則 ≥800 人)→ 不降級;低於 OIS → 降 1 級;樣本數非常小(不到 OIS 的 30%)→ 考慮降 2 級。二元結果,信賴區間的比值夠大(相對風險的 CI 比值 ≥3,或勝算比的 CI 比值 ≥2.5)→ 考慮降 2 級;否則計算 OIS,達到不降級、未達到降 1 級。
四、不一致性(inconsistency)
先看點估計值之間有沒有重要差異、而且信賴區間重疊很少;沒有就不降級,有就拿去對事先指定的臨床決策門檻(MID)比。大部分研究落在門檻的同一側就不降級;有相當比例落在相反側,就找有沒有可信的次族群解釋,找得到就分次族群呈現、在各次族群內再評,找不到才降級。
Core GRADE 要求 MID 必須定義在「絕對風險差」的尺度上(初判可以先用相對指標)。
五、發表偏誤(publication bias)
先問納入研究是不是大部分或全部都是小型、且由業界贊助——是的話降級。接著問能不能做統計檢定(統合分析裡有 ≥10 個研究):能的話看漏斗圖不對稱與 Egger 迴歸檢定,有強烈不對稱證據才降級,沒有不降級;不能的話改查試驗註冊平台與美國食品藥物管理局資料庫有沒有未發表研究的紀錄,有證據顯示研究遺失就降級。
兩個升級面向(只用於觀察性研究的統合分析)
當合併結果顯示效果很大、且內部效度沒有重大威脅時,可以從觀察性研究往上升:
| 條件 | 升級 |
|---|---|
| 效果大:相對風險 >2 或 <0.5 | 升 1 級 |
| 效果非常大:相對風險 >5 或 <0.2 | 升 2 級 |
| 有劑量反應梯度 | 升級 |
Core GRADE 刪掉了原版的第三個升級面向(殘餘干擾因子),理由是適用性有限。
相對效果怎麼換成絕對效果(原文 Table 2)
當門檻是 MID、結果是二元的時候,不精確那一格的換算步驟:
- 決定絕對風險降低的 MID。文獻或臨床經驗沒有明確門檻時,通常取 1% 到 2%
- 找出統合分析中各研究對照組事件率的中位數
- 介入組對應的風險 = 合併相對風險 × 對照組事件率中位數
- 風險差 = 第 2 步減第 3 步
- 用同樣的程序算出風險差的信賴區間
- 檢查這個信賴區間有沒有跨過第 1 步的 MID
結果以勝算比呈現時,先轉成相對風險再走上面的流程。公式是:勝算比 ÷ 〔(1 − 對照組事件率中位數) + (對照組事件率中位數 × 勝算比)〕。
不一致性那一格的換算:決定絕對風險降低的 MID → 估計研究族群的基線風險(由對照組的合併事件率或相關文獻導出)→ 算出對應 MID 的相對風險降低 → 導出對應 MID 的相對效果 → 目視比較各研究的點估計值與這個門檻。
原文引用的 Core GRADE 系列(2025 年《BMJ》)
- Why Core GRADE is needed: Introduction to a new series in The BMJ,BMJ 2025;389:e081902
- Core GRADE 1: Overview of the Core GRADE approach,BMJ 2025;389:e081903
- Core GRADE 2: Choosing the target of certainty rating and assessing imprecision,BMJ 2025;389:e081904
- Core GRADE 3: Rating certainty of evidence—assessing inconsistency,BMJ 2025;389:e081905
- Core GRADE 4: Rating certainty of evidence—risk of bias, publication bias, and reasons for rating up certainty,BMJ 2025;389:e083864
- Core GRADE 5: Rating certainty of evidence—assessing indirectness,BMJ 2025;389:e083865
同一組作者在《Dermatologica Sinica》2023 年第 41 卷 3 到 7 頁寫過舊版 GRADE 的快速教學,是這一篇的前身。
原文有兩處寫反了
導讀一篇教學文,遇到教材本身的錯要講出來,否則抄過去的人會一起錯。
一、二元結果那一條判準,句子自相矛盾。
原文寫的是:如果信賴區間夠窄(例如相對風險的 CI 比值 ≥3,或勝算比的 CI 比值 ≥2.5),作者應考慮降兩級。
「區間夠窄」是精確的意思,精確為什麼要扣分?而且 CI 比值 ≥3 本身就是「很寬」——上界是下界的三倍以上。那個 narrow 應該是 wide。照抄會誤導讀者。
二、不一致性的範例,跟同一段的規則對不起來。
規則寫的是「大部分研究落在門檻的同一側時,不需要降級」。範例卻是三個研究裡只有一個(Mayser 1998)超過 MID,另外兩個沒有——三分之二落在同一側,符合「大部分在同一側」,但作者降了一級。
原文沒有解釋為什麼。引用這個範例的時候要把這個張力一起說明,不要單獨拿去當示範。
還有幾處引用編號串錯,以及一個容易誤讀的數字
原文至少有四處引用編號指到了錯的文獻:
- 偏誤風險那一段「偏誤的方向應先被評估」後面掛的是參考文獻 [5],而 [5] 是 Kristensen 2018(魚油的隨機試驗),不是 GRADE 的方法學論文。同段其餘都引 [8]。
- 不精確那一段有三處引 [7],而 [7] 是 Soyland 1993(魚油的隨機試驗),同段其餘都引 [10]。
- 不精確的範例「based on baseline PASI values from the largest included trial (Kristensen 2018)」後面掛 [1],而 [1] 是同一組作者 2023 年的舊版 GRADE 教學文。
這些是引用管理的問題,不影響方法本身,但引用本文時不要照抄編號。
另外,利益衝突聲明把通訊作者的名字寫反了(署名 Ching-Chi Chi,聲明寫 Prof. Chi-Ching Chi)。
還有一個容易誤讀的地方:文中提到連續型結果的 OIS 經驗法則是 800 人,而魚油那個範例只有 337 人。337 小於 800 並不是這次降級的理由——作者走的是「信賴區間跨門檻」那條路徑,照流程圖這是對的,跨門檻就直接降,不必再算 OIS。
有分級和沒分級,讀起來差多少
這篇教學文和另外三篇沒有做證據分級的敘事性回顧,登在同一期期刊上。
一篇談乾癬病人的降血糖藥與降血脂藥,一篇談化膿性汗腺炎的全身治療,還有一篇談類天皰瘡的水皰是怎麼形成的。三篇都沒有檢索策略、沒有偏誤評估、沒有分級,所以同一本期刊裡就出現了兩種讀法:乾癬打瘦瘦針有用嗎?降血糖藥與降血脂藥、〈化膿性汗腺炎怎麼治?從抗生素到 JAK 抑制劑〉、〈類天皰瘡的水皰,跟白血球撒的網有關嗎?〉。想看「一篇有標把握分數」和「一篇沒標」擺在一起差多少,就把那三篇跟這一篇並排讀。 類天皰瘡那一篇最明顯:它整理了十幾條機轉,但沒有一條在病人身上試過,而原文沒有任何一個地方告訴你這件事——要自己讀出來。
同一個把數字攤開看的動作,我在另一篇做過一次。美國皮膚科醫學會的電子報說 spironolactone 對外用 minoxidil 有「加乘效果」,而三個用儀器數出來的客觀指標方向全部偏向它、卻沒有一個跨過 0.05 的門檻:〈把 P 值攤開,「加乘」兩個字就站不住了〉。那一篇處理的是「摘要挑了最好聽的那一句」,這一篇處理的是「連結論本身的把握也要標出來」。如果你想知道那三個停在門檻外的 P 值該怎麼讀,這一篇的五個問句就是那套流程。
所以,現在該怎麼看待魚油
回到藥妝店那一排盒子。
這篇不是叫你把家裡的魚油丟掉,也不是叫你去買。 它給的是一個更準的答案,而那個答案要分兩邊講,缺一邊就會被讀錯。
往一邊講:「不確定」不等於「可能有用」。 那個平均差是 −0.28,小到看不見;三個試驗確實沒有做出效果。任何人拿這篇去說「所以魚油其實有效」,是把不確定讀成了有希望。
往另一邊講:「不確定」也不等於「已經有答案」。 337 人、三個高偏誤風險的試驗、一段橫跨兩個相反結論的可能範圍——這不足以把這個問題關掉。誠實的說法是:目前沒有足夠好的資料。
那麼在診間該怎麼辦?拿一個真的做出效果的東西來對照,你就會知道差別有多明顯。站上導讀過一種治乾癬的口服小分子藥,量的是同一把 PASI 尺:十六週達到 PASI75(乾癬嚴重度降低七成五)的比例是 58.4%,安慰劑組 12.7%——〈乾癬治療新星:Sotyktu〉。把 −0.28 跟這一組數字擺在一起,差別是一眼的事。如果你的乾癬正在影響生活,真正該花時間討論的是那一類選項,不是保健食品架。
魚油這一邊也有它的代價,要一起說。它每個月要花錢;它跟抗凝血藥物有交互作用,手術前後要不要停也得問過醫師或藥師。這篇原文完全沒有處理魚油的安全性,所以這裡不給任何數字,只給一句:那是要問人的事,不是自己查得完的事。
順帶一個對照,可以看出「有沒有做出來」在同一顆膠囊上差多少。泰國一個 80 人的隨機對照試驗,把魚油加在口服 A 酸上治痘痘——那一次量到了東西:角質層含水量的組間差 11.10,三酸甘油酯的上升幅度組間差 −10.9 mg/dL,兩個信賴區間都沒有跨過 0:〈吃 A 酸的時候,那顆魚油到底幫不幫得上忙〉。同一顆魚油、不同的問題,一個量到了、一個沒有。 保健食品有沒有效,要一題一題算。
你不必會算 GRADE,但你可以問一句:「這件事的證據等級是什麼?」
這是每一個人都問得出口、而醫師答得出來的問題。答案如果是「很確定」,你可以放心。答案如果是「非常低」,你至少知道自己在賭什麼。
這篇教學文沒有回答的
- 只涵蓋「單一介入對單一對照」的成對比較。 網絡統合分析、多重比較、預後研究、診斷準確度、質性研究都不在範圍內——而皮膚科現在最常被問的問題(「三種生物製劑哪一種好」)正是網絡統合分析。
- 沒有給出 MID 從哪裡來的通用方法。 而 MID 選什麼幾乎決定了最後降幾級。
- 沒有處理兩個評分者意見不同時怎麼辦。 只說要兩個人獨立評,沒講仲裁流程。
- 沒有信度資料。 沒有任何 kappa 值或評分者間一致性的數字,支持「Core GRADE 比舊版更一致」這個主張。
- 沒有和舊版 GRADE 做對照示範。 同一篇魚油研究用舊版評會得到什麼,沒有說。
- 兩個升級面向都沒有實際示範,因為範例只有隨機試驗。
- 「非常低」之後該怎麼辦沒有說。 一個結果被評成最低等級,臨床上要怎麼用它——這超出本文範圍,但對讀者最重要。
參考文獻
- Shao SC, Kuo LT, Huang YT, Lai PC, Chang KC, Chi CC,Core Grading of Recommendations Assessment, Development, and Evaluation tutorial: Rating certainty of evidence in outcomes from pairwise systematic reviews and meta-analyses,Dermatologica Sinica 2026;44(3):207–211 doi:10.4103/ds.DS-D-26-00091
- Guyatt G 等,Core GRADE 1: Overview of the Core GRADE approach,BMJ 2025;389:e081903 doi:10.1136/bmj-2024-081903
- Yang SJ, Chi CC,Effects of fish oil supplement on psoriasis: A meta-analysis of randomized controlled trials,BMC Complement Altern Med 2019;19:354
- Kristensen S 等,Beneficial effect of n-3 polyunsaturated fatty acids on inflammation and analgesic use in psoriatic arthritis: A randomized, double blind, placebo-controlled trial,Scand J Rheumatol 2018;47:27–36
- Mayser P 等,Omega-3 fatty acid-based lipid infusion in patients with chronic plaque psoriasis: Results of a double-blind, randomized, placebo-controlled, multicenter trial,J Am Acad Dermatol 1998;38:539–547
- Søyland E 等,Effect of dietary supplementation with very-long-chain n-3 fatty acids in patients with psoriasis,N Engl J Med 1993;328:1812–1816
本文僅供衛生教育參考,不能取代專業醫師的診斷、治療或處方。實際用藥種類、強度與療程需由醫師依個別病況判斷。若症狀急速惡化、大面積起水泡、合併發燒或傷口化膿,請立即就醫。